
AI開発・実運用
CodexとClaude Codeを並列で動かして分かった。AIエージェント開発で本当に難しいのは『状態管理』だった
複数AIの並列運用で分かった、State・Authority・Evidence・Recoveryの設計。
公開日:2026年9月9日 更新日:2026年9月20日 著者:飯田 友広(Tomohiro Iida)
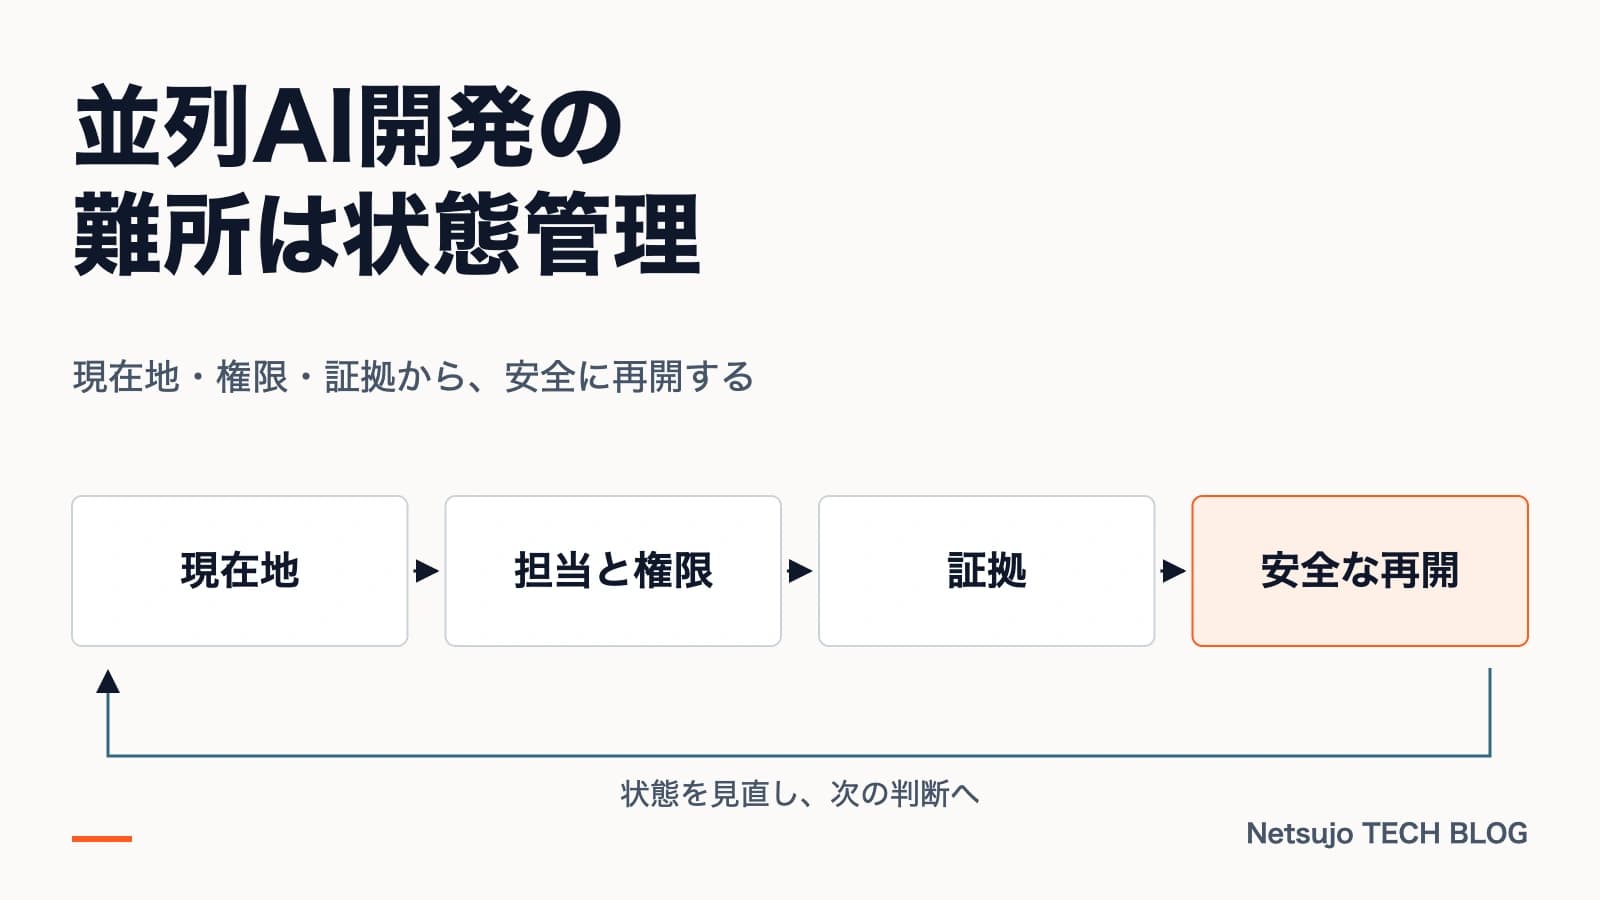
この記事の結論
複数AIでは、モデル性能より先に「誰が何をどこまで進めたか」という状態管理が難しくなりました。
チャットを正本にせず、GitHubと永続化されたControllerから現在状態を再構築する方が復旧性は高まります。
recoverableなRuntime停止は人間の「再開」巡回に頼らず再評価し、OUTCOME_UNCERTAINや一般的なBLOCKEDは自動retryしません。
single writer、Exact-headのCI/QC、restart safetyとlivenessを運用ルールとして持つ必要があります。
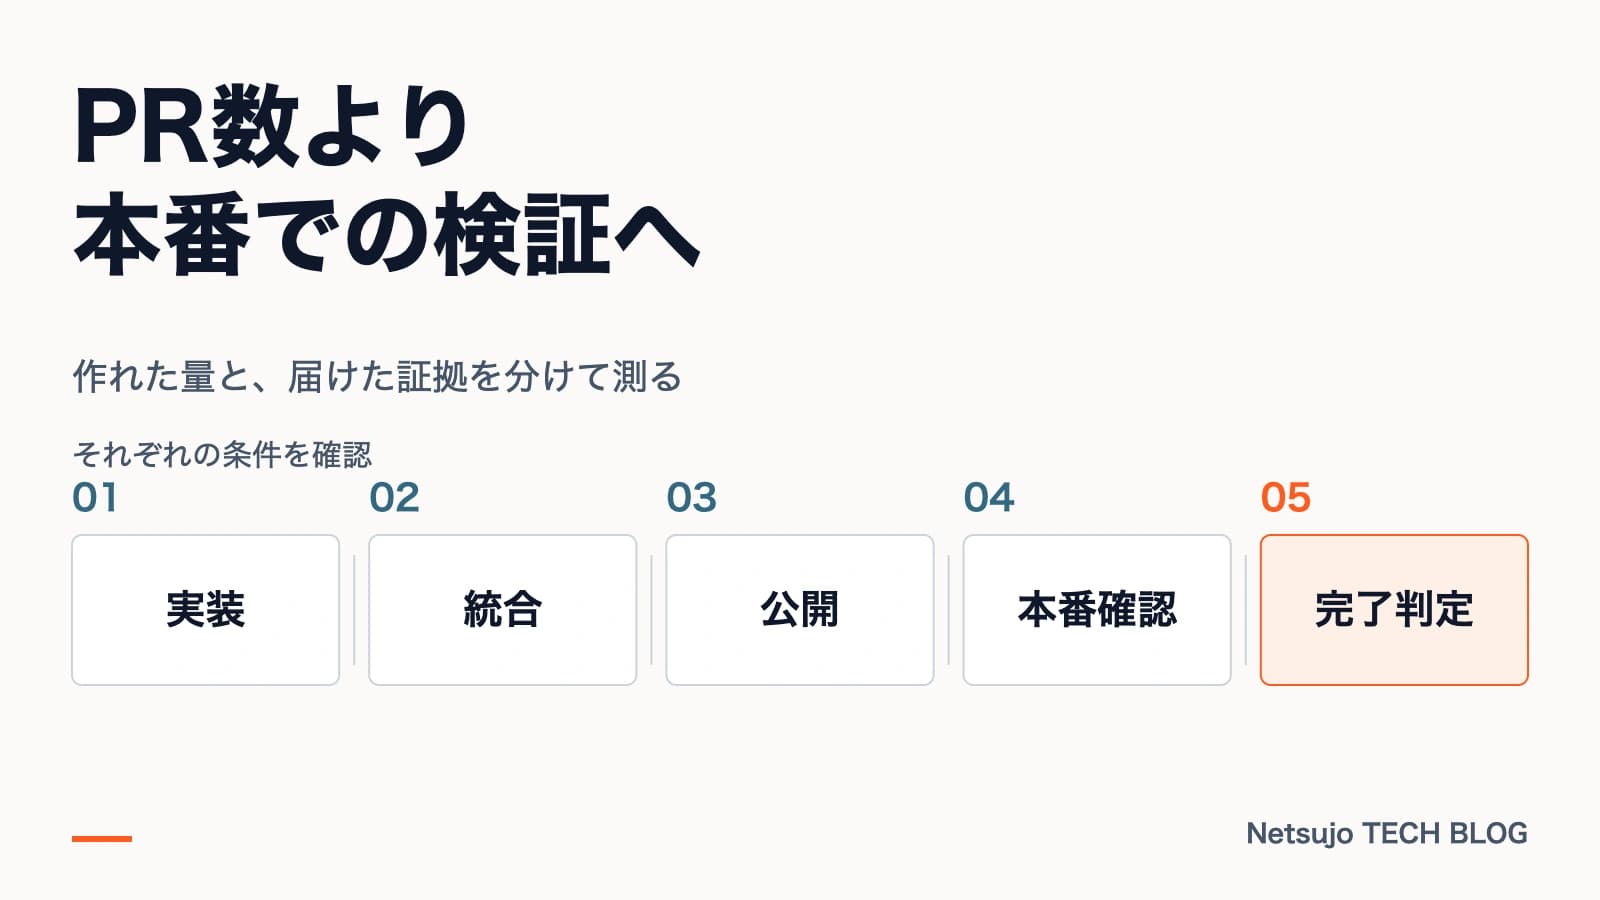
Controllerの高度さ自体をKPIにせず、実際の仕事と事業成果が安全かつ速く進んだかで評価します。
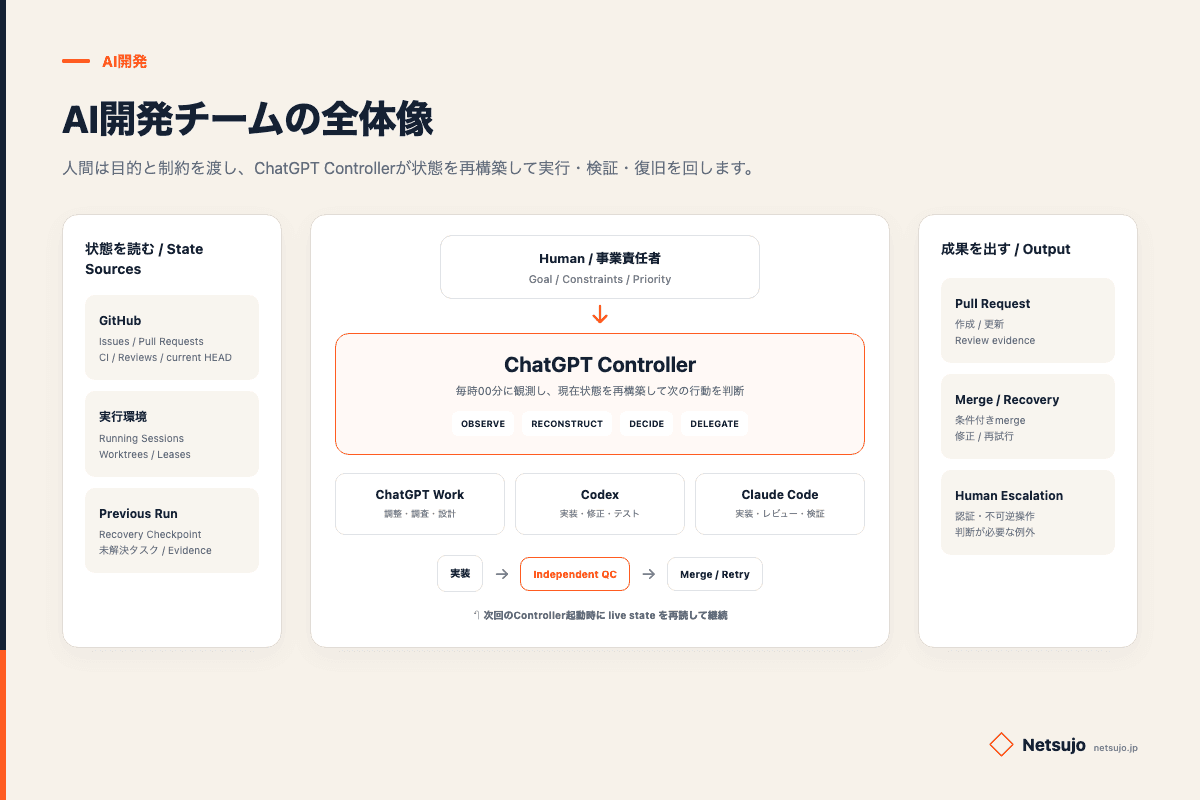
SINGLE AGENT
追跡する状態が少ない
MULTI AGENT
同時に追跡する状態が増える
STATE TRANSITION
BLOCKED
必要な権限・レビュー・外部条件が揃わない場合は、品質ゲートを飛ばさず停止します。
OUTCOME_UNCERTAIN
外部変更の成否を証明できない場合は、二重実行を避けるためblind retryしません。
生成AIにコードを書いてもらうこと自体は、以前ほど難しくありません。
仕様を渡せば実装してくれます。テストを書き、エラーを調べ、Pull Requestを作ることもできます。最近では、コードレビューまでAIに任せられます。
では、CodexやClaude CodeのようなAIエージェントを複数並列で動かせば、開発速度はそのまま2倍、3倍になるのでしょうか。
実際に複数のAIエージェントを並列で動かしながら開発を続けてみると、そう単純ではないことが分かりました。
難しかったのは、AIのコーディング能力そのものではありません。
誰が、何を、どこまで進めていて、何が確認済みで、次に何をしてよいのか。
最も難しかったのは、この「状態管理」でした。
AIエージェントを増やすと、生産性より先に「調整の複雑さ」が増えました
最初は比較的シンプルでした。Codexに実装を任せ、Claude Codeにはレビューを任せます。別のタスクであれば、それぞれ並列で進めてもらえます。一人で順番に開発するより、実装そのものは明らかに速くなりました。
ところが、対象となるリポジトリやPull Request、タスクが増えるにつれて、別の問題が表面化しました。
- 別のエージェントが同じファイルや機能を編集し始める
- レビューしている間に対象のHEADが変わる
- すでに解決済みの問題を別のエージェントがもう一度実装する
- CI待ちなのか、レビュー待ちなのか、単に処理が停止しているのか分からなくなる
- 会話が切れると、どこまで終わっていたのかを復元するところから始まる
- 外部APIやデプロイ処理が、本当に成功したのか判断できない状態が発生する
AIを増やせば、単純に処理能力だけが増えるわけではありません。同時に存在する「作業中の状態」も増えます。
その結果、並列化による速度向上より先に、調整の複雑さが大きくなっていきました。
そこで、仕事を依頼するAIに加えて、AIエージェントを管理するためのControllerを作り始めました。
「チャット」を状態管理の正本にしてはいけませんでした
最初に痛感したのは、チャット履歴は作業状態の正本には向いていないということです。
短い作業であれば「さきほどの続きをお願いします」でも十分です。しかし、複数のリポジトリ、Pull Request、CI、レビュー、デプロイが並行し始めると、会話の中に異なる時点の情報が混在します。
「このPRはCI通過済みです」「ただしレビュー結果は一つ前のHEADに対するものです」「こちらはマージ済みですが、本番確認はまだです」といった情報は、時間とともに古くなります。
そこで運用方針を変えました。
GitHubと永続化されたControllerの状態を正本とし、チャットは操作インターフェースとして扱います。
AIが再起動しても、新しい会話になっても、現在のmain、Pull Request、担当、CI、レビュー、残タスクを読み直せば、現在地を再構築できます。
AIに大量の記憶を持たせることよりも、AI自身が正しい現在地を再構築できる仕組みを持たせることの方が重要でした。
この考え方を、私たちは「Reconstruct before Act」として運用しています。行動する前に、まず現在状態を取り直します。
並列実行で重要なのは「誰が変更してよいか」を明確にすることでした
複数のAIエージェントを動かす場合、Git worktreeを分ければ安全だと考えがちです。worktreeによる分離は有効ですが、それだけでは不十分でした。
別々の作業場所にいても、最終的には同じ機能、同じブランチ、同じ意味領域を変更する可能性があります。
そこでControllerでは、一つの変更対象に対して、同時に一つのmutating writerだけを認めるという考え方を強くしました。
実装担当には一定期間の変更権限を持たせ、単純なファイルに加えて、認証、課金、デプロイなど意味的な変更領域でも競合を確認します。別のエージェントが同じ領域を書こうとした場合は、処理を止めます。
並列化で重要なのは、できるだけ多くのAIを同時に動かすことではありません。
安全に分離できる仕事だけを並列化することです。
ここを間違えると、エージェントを増やすほど統合作業と手戻りが増えます。
「レビュー済み」という情報だけでは不十分でした
AIによるレビューでも、状態管理の問題がありました。
「Claude Codeでレビュー済みです」という情報だけでは十分ではありません。レビューが終わった後に1コミット追加されていれば、そのレビュー結果は現在のコードには適用できないからです。
そこで必要になったのが、どのcandidate HEADに対するレビューなのかを固定することでした。
CIも同じです。「このHEADに対して、このCIが通りました」という形まで記録します。
さらに、実装したAI自身がレビューして問題なしと判断しても、それを独立レビューとは呼びません。そのため、実装、CI、Independent Reviewerを分離しました。
重要なのは、どのモデルが上かという比較ではありません。
実装と評価の独立性を、運用ルールとして保証することです。
詳しいExact SHAの考え方は、PR番号ではなくExact SHAで検証対象を固定するで整理しています。
一番危険だったのは「成功したか分からない状態」でした
Controllerを作る中で、特に重要だと感じた状態があります。それが OUTCOME_UNCERTAIN です。
たとえば、外部APIへ変更要求を送った直後に通信が切れたとします。クライアント側ではエラーに見えても、サーバー側では処理が完了している可能性があります。
ここで「エラーになったので、もう一度実行します」とすると、処理が二重に実行される危険があります。Git push、デプロイ、課金、メール送信、データベースmigrationなどでは特に問題になります。
そのため、成功したことも失敗したことも証明できない場合は、自動で再実行しないという状態を明示的に持たせました。
失敗なら再試行できます。成功なら次へ進めます。しかし「分からない」は、そのどちらでもありません。
AIエージェント運用では、この第三の状態を設計に入れる必要があります。
自律化では「長時間動き続けること」より「正しく再開できること」を重視しました
当初は、AIを長時間動かせるほど自律性が高くなると考えていました。しかし、本当に重要だったのは、途中で停止しても、次の実行が正しい場所から再開できることでした。
長時間のセッションはいずれ切れます。ネットワークが切れることもあります。モデルの利用上限、CI待ち、外部サービスの障害もあります。
そのため、仕事全体を状態遷移として扱うようにしました。
通常は、QUEUEDからREADY、IMPLEMENTING、WAIT_CI、WAIT_REVIEW、REVIEWINGを経てCOMPLETEへ進みます。進行できない場合はBLOCKED、外部変更の結果を確定できない場合はOUTCOME_UNCERTAINとして扱います。
こうしておけば、プロセスそのものが停止しても状態は残ります。次のControllerが状態を読み直し、続きを判断できます。
自律性とは「止まらないこと」ではありません。
止まっても、状態を壊さず再開できることです。
Controllerを作ったのに、人間が「再開」を押していました
ここまでの仕組みを入れても、運用上の穴が一つ残りました。
Controllerには、実装RuntimeやReviewer Runtimeが戻ったときに状態を再評価する reconcile() がありました。しかし、continuation serviceはprojected stateが BLOCKED になると終了していました。
この組み合わせでは、復旧ルールを持っていても、そのルールを後から実行するプロセスが残りません。
たとえばReviewer Runtimeの枠が一時的に埋まり、タスクが BLOCKED_REVIEWER_UNAVAILABLE になったとします。その後に枠が空いても、continuationが終了済みならControllerは自分から再評価できません。人間がチャットや実行主体を見回り、「再開」と入力して初めて次の reconcile() が走ります。
これは、状態管理を自動化したのに、人間がschedulerとして残っている状態です。
直近の内部修正では、continuationを生かしたまま待ってよい停止理由を三つに限定しました。
BLOCKED_IMPLEMENTER_UNAVAILABLEBLOCKED_REVIEWER_UNAVAILABLERUNTIME_SNAPSHOT_STALE
この三つは、Runtimeの可用性や観測鮮度が回復すれば、既存のController reconcile() が安全に再評価できる状態です。
一方、すべての BLOCKED を自動再開する設計にはしていません。
- writer handoffの権限は変えない
- lease / ownershipの意味も変えない
- duplicate dispatchを増やさない
- unknown mutation outcomeをretryしない
OUTCOME_UNCERTAINはterminalのままにする- 実際にlaneをreopenする権限はController
reconcile()に残す
ここで消したかったのは、人間の判断ではありません。客観的にrecoverableと分かっている停止状態を見張るためだけの人間heartbeatです。
「AIが止まったら自動で再試行する」という一般ルールでは危険です。自動継続してよい状態を列挙し、それ以外は止める方が安全です。
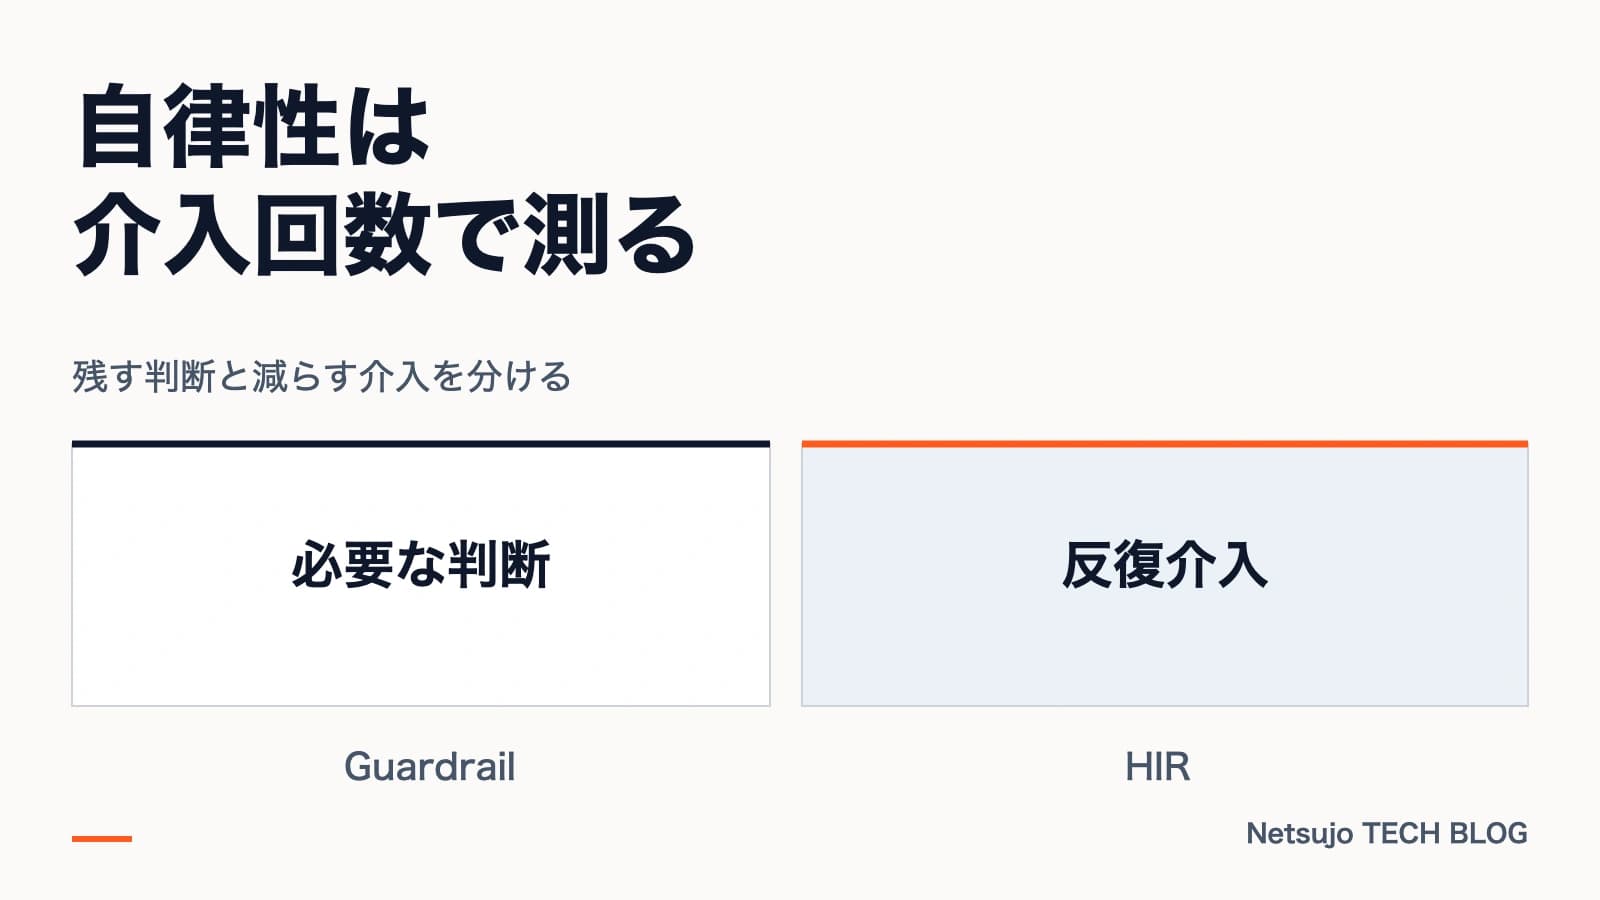
人間の役割を、空いた枠を見つけて「再開」と送る作業から、例外・曖昧さ・事業判断を扱う仕事へ戻す。そのためにはRecoveryだけでなく、Recoveryを人間なしで再評価できるlivenessまで設計する必要がありました。
AIが使えなくなることも「通常状態」として扱う必要がありました
実運用では、特定のAIランタイムが利用できなくなる場面もあります。
ここで「このAIが使えないので、すべての作業を停止します」という構造にすると、システム全体が一つのモデルやサービスに依存します。
そこでController側では、AIの利用可否も状態として扱います。あるAIが利用できなければ、条件を満たす別の実行先へ振り分けます。独立レビューを行える実行先が存在しない場合は、レビューを省略せずBLOCKEDにします。
モデルや外部サービスは止まることを前提にし、その時点で利用できる能力と権限から、進めてよい仕事だけを選ぶようにしました。
24時間の実運転では「進めた数」より「止めた判断」が重要でした
この考え方が実際に機能するかを、2026年9月8日13時16分から翌9日13時16分までの運用記録で振り返りました。
印象的だったのは、大量のPull Requestを作れたことではありません。むしろ、進めてはいけない変更を止められたことでした。
CIが通っていても、独立QCでHIGHなら止めました
あるController候補はLinuxとDarwinのHosted CIを通過していました。しかし、その後の独立互換性QCで、既存の永続化データに影響し得るHIGHの問題が見つかりました。
その候補は受入対象から外し、Ready、merge、deploy、Productionへ進めませんでした。修正時にも既存writerの担当を保持し、second writerを追加していません。
CIが緑であることと、現在の候補を受け入れてよいことは別です。
HEADが変われば、古いPASSを捨てました
別の変更では、最初の候補がruntime検証で失敗し、次の候補は別の互換性問題で止まりました。修正後の最終HEADに対して、必要なCIと別セッションの独立QCを取り直し、条件が揃った候補だけを次工程へ進めました。
以前のHEADで取得したPASSは、新しいHEADの証拠として流用しません。
約1秒の高速化を不採用にしました
CIのcheckout時間を短縮する実験では、およそ8秒から7秒へ改善しました。一方、独立QCでは、条件によって差分判定の正しさを損なう可能性がHIGHとして指摘されました。
約1秒の改善に対してリスクが大きいと判断し、その変更は採用しませんでした。
変更できることと、変更する価値があることは別です。 不採用もControllerの重要な出力です。
チャットが途切れても、GitHubの現在状態から復旧しました
同じ24時間の中では、チャットや通信の失敗から復旧する場面もありました。以前の会話を唯一のタスク台帳にせず、GitHub上のcommand centerとlive readbackから、main、Pull Request、CI、レビュー、担当、残タスクを再構築しました。
ここでも必要だったのは「前の会話を完全に覚えていること」ではありませんでした。
次の行動に必要な現在状態を、正本から復元できることでした。
Controller改善そのものが目的になる危険もありました
一方で、反省もあります。
Controllerを改善していくと、改善点はいくらでも見つかります。状態管理、権限管理、独立レビュー、restart safety、credential isolation、runtime routing。やろうと思えば際限なく改善できます。
しかし、ここには大きな罠があります。
Controllerを改善すること自体が目的になってしまうことです。
本来、Controllerはプロダクトや事業の開発速度と品質を高めるための手段です。Controllerの完成度が上がっても、顧客価値や事業成果が増えなければ意味がありません。
そのため、見るべきKPIを「Controllerがどれだけ高度になったか」から、Controllerによって実際の仕事がどれだけ安全かつ速く完了したかへ移す必要があります。
自動化を自動化することは簡単に自己目的化します。AIエージェント時代には、特に注意すべき点だと考えています。
人間の仕事は「コードを書く」から「状態とルールを設計する」へ変わりつつあります
ここまでControllerを作り込んで、最も大きく変わったのは自分自身の仕事でした。
以前は「この機能をどう実装するか」を考える時間が中心でした。現在は、それ以上に「この仕事の完了条件は何か」「誰が変更してよいのか」「どの証拠が揃えば次へ進んでよいのか」「途中で止まった場合にどう復旧するのか」を考える時間が増えています。
つまり、優れたプロンプトを書くだけでは、AIエージェントを使いこなせませんでした。
仕事そのものを、機械が安全に実行できる状態遷移へ変換することでした。
CodexもClaude Codeも今後さらに進化していくでしょう。だからこそ、モデルの能力差だけを見ず、次の5つを設計する必要があります。
- State — 現在どこまで進んでいるのか
- Authority — 誰が何を変更してよいのか
- Ownership — 誰が現在の仕事を持っているのか
- Evidence — 何を根拠に完了と判断するのか
- Recovery — 止まったとき、どこから再開するのか
AIがコードを書けるようになったことで、人間の仕事がなくなったわけではありません。人間の仕事が、より上位のレイヤーへ移動し始めています。
「誰に何をさせるか」に加えて、「仕事が正しく進んだとは、どのような状態なのか」を設計する。
複数のAIエージェントを実運用してきて、現在もっとも重要だと感じているのは、この部分です。
観測範囲について:24時間の具体例は2026年9月8日13:16〜9月9日13:16のGitHub運用記録を公開可能な範囲に抽象化して整理しています。人間の実介入時間はGitHub履歴だけでは正確に復元できないため、推測値は掲載していません。
この記事の著者
飯田 友広
代表取締役
Netsujo株式会社 代表取締役。Technical BizDev / AI Deploymentとして、顧客の業務課題、AI適用領域、PoC、実装チームとの要件、本番導入後の評価をつなぐ。京都発のWeb3・AI実装スタートアップを2023年6月に創業。Webサイトを営業基盤として捉え、経営・営業・検索・生成AI・コンバージョン・計測を横断して課題と改善優先順位を整理する「Netsujo SIGNAL」を設計・運営。さらに、ChatGPT・Codex・Claude Codeを状態再構築、競合回避、独立QC、Exact-head検証、停止、復旧まで含む制御ループで運用する社内AI開発基盤「Netsujo Agent OS」を設計・実運転。Netsujoとして京都ビッグデータ活用プラットフォームに参画(小規模企業会員(ベンチャー))し、同プラットフォーム発のワーキンググループ「Chain Up KYOTO」にも参画(2026年3月10日〜)。IVS2026サイドイベント「なぜ京都でWeb3.0ビジネスなのか」はNetsujoとして京都府庁旧議場で主催・企画・登壇・運営(2026年7月2日/京都府 総合政策環境部 デジタル政策推進課は共催)。京都美術工芸大学・龍谷大学での講義に加え、京都高度技術研究所(ASTEM)、旅館業界、就労支援施設、Open Source Conference等で登壇実績。ITコミュニティ「みやこでIT」(connpassメンバー639名・イベント176件・2019年2月から運営)運営。NPO法人NEMTUS理事、BAR KRYPTO運営。Netsujoはソーシャル企業認証制度「S認証」の認証企業(2026年2月認証・2026年4月公表)。技術領域はWeb3/ブロックチェーン/DID/NFT/生成AI/コミュニティ運営。
プロフィールを見るこの記事が向いている方
複数のAIコーディングエージェントを並列利用し、人間の管理負荷が増えている方
AIエージェントのタスク割当・QC・復旧を人手から切り離したい開発責任者
AI開発の自律化を、安全な制御として設計したい方
— 壁打ち相談
読者のよくある相談
記事を読んだ後に「自分の状況だとどう判断すべきか」を整理するための壁打ち相談を受け付けています。下記のような相談例が当てはまる方は、お気軽にご連絡ください。
Q. AIを増やしたのに、自分がAIの進捗確認で忙しくなっている
実装の自動化と、AIを管理する仕事の自動化を分けて考えます。
Q. 複数AIが同じ領域を触ったり、古いレビュー結果を使ってしまう
担当leaseとexact-head CI/QCを受入条件へ組み込みます。
Q. チャットやセッションが切れると、作業状況の説明からやり直しになる
チャットを記憶、GitHubを現在状態として、Reconstruct before Actで復旧します。
上記いずれかが該当する場合、初回30分の壁打ち相談で論点整理に対応します。記事に書ききれない個別事情を踏まえた判断材料が必要な段階こそ、壁打ちが活きやすいフェーズです。
AI導入・開発運用のご相談
AIチームを増やす前に、状態と権限を設計する
PoCや単発実装だけでなく、誰が進め、誰が止め、どの証拠で完成とするかまで含めて設計します。