
AI開発
AIを増やす前に、役割と実行先を分ける。
固定3AI分業から、RoleとRuntimeを分けた資源配分へ
著者:飯田 友広(Tomohiro Iida)
この記事の結論
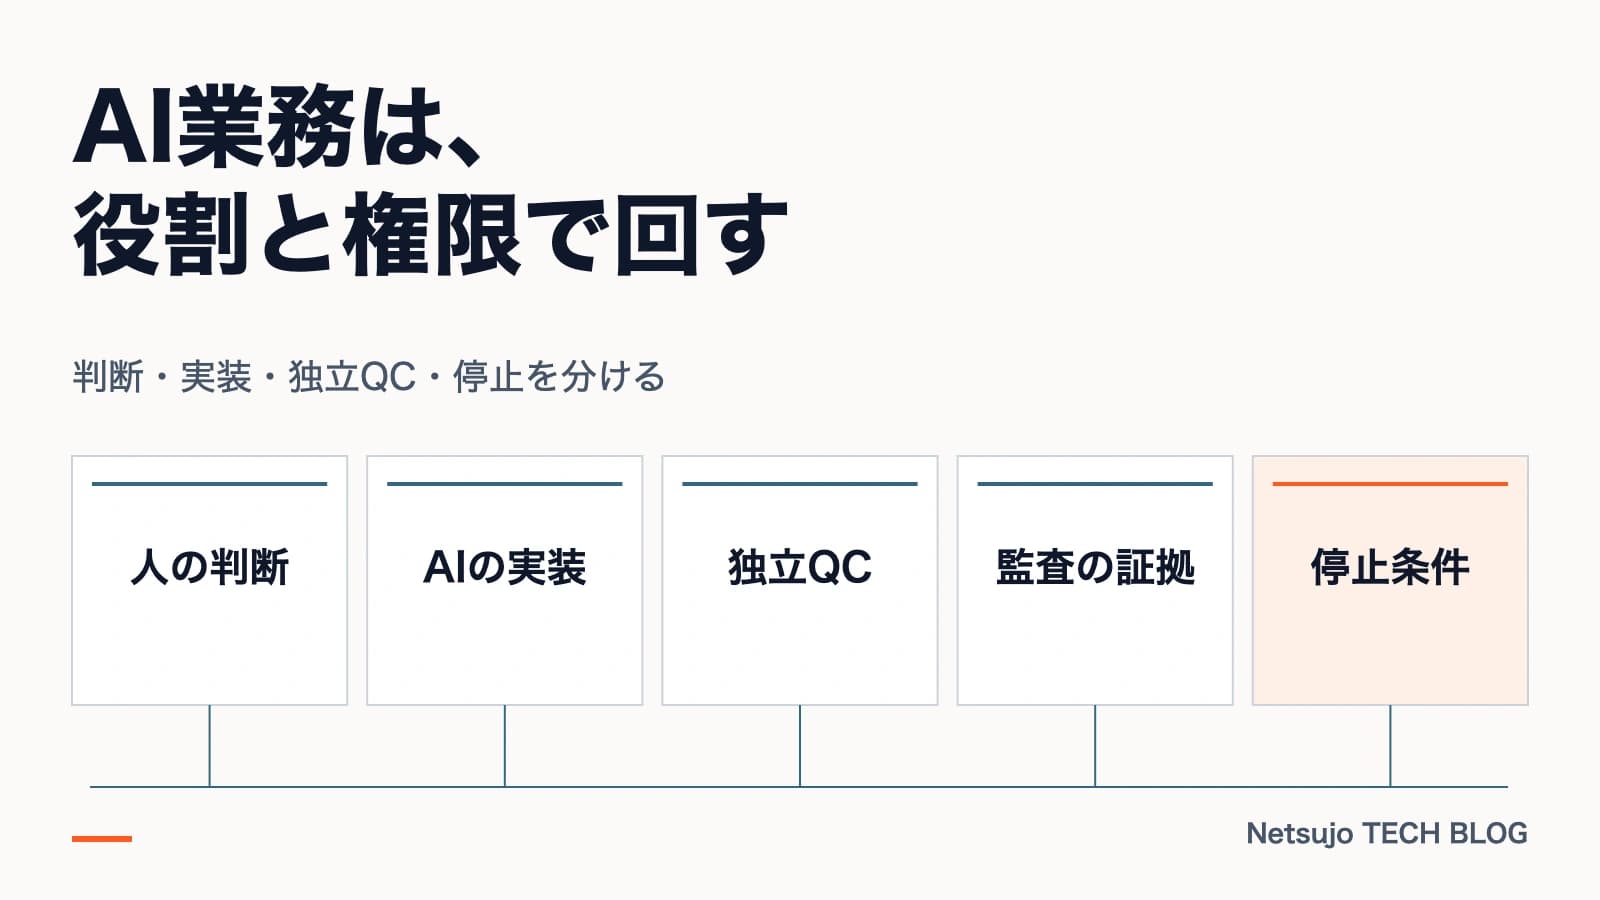
設計・実装・独立レビューのRole分離は維持します。製品名を固定担当へすることはやめました。
実行RuntimeはCapability・Authority・fresh quota・live capacityから選び、希少な枠を戦略作業と独立QCへ残します。
機械検査で判定できる問題はLLMレビューより先に処理し、Independent Reviewは別AssignmentでExact HEADへ結びます。
Reviewer Runtimeが使えないときもレビュー要件は消しません。代替RuntimeがなければBLOCKEDにします。
2026年夏、Netsujoでは一部の実装を次の固定フローで進めていました。
- ChatGPTで目的、要件、制約、受け入れ条件を整理する
- Claude Codeがリポジトリを調査し、実装とテストを行う
- Codexが完成直前の差分を独立監査する
- 人間が指摘の採否と公開可否を決める
この分業は有効でした。一人の主担当者が設計から自己レビューまで抱える状態を避け、実装と評価の権限を分けられたからです。
その後、別のボトルネックが見えてきました。
Claude Codeの枠が埋まる。Codexの利用可能量を戦略作業へ残したい。残容量は十分でも、同時実行枠が別の作業で使われている。監査Runtimeが止まったときに、レビュー要件そのものまで消してよいのか。
固定した製品名だけでは、この問題を扱えません。
現在は、RoleとRuntimeを分けて管理しています。
- Role:設計、実装、独立レビュー、検証、最終判断
- Runtime:そのRoleを実行するChatGPT、Claude Code、Codexなどの実行環境
- Capability / Authority:そのRuntimeが今回の仕事を実行してよいか
- Quota:残り利用枠はどれだけあるか
- Live capacity:今この瞬間に新しい仕事を受けられるか
- Reserve:希少なRuntime枠を、より重要な用途へどれだけ残すか
2026年9月18〜19日には、この考え方をAgent OSの実装へ反映しました。Claude CodeとCodexの残容量を正規化し、canonicalなeligibilityを通ったRuntimeだけを候補にし、Codex容量の一部を戦略的な対話作業とcross-runtime QCへ残すようにしています。旧Claude background entrypointも同じquota-aware dispatcherへ接続し、古い経路から割当方針を迂回できないようにしました。
役割分離で得たものを残しつつ、運用は「どのAIに固定するか」から「有限のAI資源をどう配るか」へ進みました。 その変化を、実装と運用の両面から整理します。
最初は、役割を三つのAIへ固定しました
少人数開発では、要件を考えた人が実装指示を出し、そのまま完成判定まで行いがちです。最初の前提が検証されないまま残るため、Netsujoでは意図的にRoleを分けました。
当初の主担当は次の構成でした。
| Role | 当時の主担当 | 主な仕事 | 権限 |
|---|---|---|---|
| 事業・設計整理 | ChatGPT | 顧客価値、目的、要件、非目標、受け入れ条件を言語化する | 設計情報と参考資料を扱う |
| 実装 | Claude Code | リポジトリ調査、コード変更、テスト、ビルド、修正 | 作業ブランチ上のコードを編集する |
| 独立監査 | Codex | 差分、仕様、テスト結果を照合し、重大な欠陥を指摘する | 読み取り専用を原則とする |
| 統合・公開判断 | 人間 | 指摘の採否、優先順位、リスク許容、公開可否を決める | 最終決定と責任を持つ |
この構成で得た最大の価値は、実装した主体と、それを評価する主体を分けたことです。
異なる製品を使うだけで独立性は成立しません。実装AssignmentとReviewer Assignmentを分け、レビュー対象をExact HEADへ固定し、評価側の変更権限を制限し、終了条件を先に決めて初めて独立性が生まれます。
固定分業の次に詰まったのは「使えるAI枠」の配分でした
役割分離を続けると、次はRuntimeの可用性がボトルネックになりました。
ここでは少なくとも四つを分けて見ます。
| 観測 | 意味 |
|---|---|
| Eligibility | そのRuntimeが必要なRole・権限・安全条件を満たすか |
| Quota | 5時間・7日などの利用枠がどれだけ残っているか |
| Live capacity | 別セッションが枠を使っておらず、今すぐ開始できるか |
| Guard health | budget guardや実行境界が正しく保護されているか |
残量が多いだけでは実行許可になりません。
2026年9月19日の運用ではClaude Codeの5時間枠に十分な残量があっても、別の正当なinteractive sessionが共有枠を使っていたため独立QCを開始しませんでした。同じ時点でCodexはbudget guard monitorの保護状態を証明できず、残量評価以前にRuntime候補から外れました。
この区別がないと、「トークンが残っているから使う」「第一候補が使えないからレビューを省く」といった誤ったfallbackが起きます。
現在のsource-owned policyでは、Codexの一部容量をstrategic interactive workとcross-runtime QCへ残す設計を採用しています。具体的な予約値は内部運用値として扱い、一般的な推奨値としては公開しません。
重要なのは閾値そのものより、有限のAI枠を会社の資源として配分する考え方です。
ChatGPTに設計させる理由
私の役割はBizDevを起点としており、最初に考えるのはコードではなく、顧客、事業、導線、売上、運用です。
たとえば「分析画面へ顧客のゴールを入力できるようにする」という要望にも、複数の論点があります。
- 誰が入力するのか
- 何のために入力するのか
- ゴールは一つか複数か
- 自由記述か選択式か
- 入力内容が分析ロジックへどう影響するのか
- 既存画面のどこを維持するのか
- 今回は変更しない範囲がどこか
- 何をもって完成とするのか
これらを整理せずに「ゴール入力欄を追加して」とだけ伝えると、AIは不足した前提を推測で埋めます。実装速度が速いほど、曖昧な前提も速くコードになります。
ChatGPTには、実装コードを書かせる前に、要求を次の項目へ変換させます。
- 目的
- 現状
- 解決したい問題
- 対象ユーザー
- 必須要件
- 変更してはいけない条件
- 非目標
- 受け入れ条件
- 想定リスク
- 確認方法
- 未確定事項
ここで重要なのは、詳細なファイル名や実装方法を先回りして決めすぎないことです。
ChatGPTがリポジトリの現状を十分に確認できていない場合、細かな実装指定は誤った前提を固定します。Markdown指示書は完成コードの設計図というより、事業要求と実装結果を照合するためのTask Contractとして使う方が有効です。
設計書の品質は文字数では決まりません。目的、制約、受け入れ条件、非目標が正しいかで決まります。
実装Roleに必要なのは「実際のリポジトリを扱えること」です
設計書が正しくても、実際のリポジトリには既存の規約、依存関係、未コミット変更、テスト、CI、過去の設計判断があります。
Claude Codeには、指示書をそのまま実行させるのではなく、最初に次を調査させます。
- 現在のブランチとworking treeの状態
- 対象機能の既存実装
- 関連する型、API、データモデル
- 既存のlint、typecheck、test、buildコマンド
- GitHub Actionsで実際に使われている検査
- 既存の失敗と今回の変更で増えた失敗の区別
- 指示書とリポジトリの現実が矛盾していないか
矛盾があれば、実装前に次の形式で差分を報告させます。
- 指示書が前提としている状態
- 実装上そうなっていない箇所
- 取り得る案と、それぞれの影響範囲
- 今回の目的に照らした推奨案
これにより、指示書が誤っていても、その誤りを忠実に実装する事態を防ぎます。
当初はClaude Codeを主実装Runtimeとして使いました。現在は実装Roleを製品名へ固定せず、canonical policy上のCapability・Authority・利用可能性を満たすRuntimeへ割り当てます。実装者自身の自己評価を独立レビューには数えない点は変わりません。
独立レビューは「Codex固定」からRuntime-independentへ
当初はCodexを独立監査の主担当にしていました。実装者とは別のコンテキストから差分を見ることで、実装側が当然視した前提を疑える場面があったからです。
現在は、独立レビューというRoleと、CodexやClaude CodeというRuntimeを分けています。
レビュー要件はRuntimeの都合で消しません。
- 実装Assignmentと同じAssignmentを独立レビューとして採用しない
- 対象HEADを固定する
- 機械検査がFAILまたは未実施なら、先にそこを直す
- Reviewer Runtimeが利用可能なら、source-owned policyに従って一つ選ぶ
- 第一候補が利用不能でも、独立レビュー要件は維持する
- reviewer-capableなRuntimeが一つも使えなければBLOCKEDにする
- Ownerの判断だけを独立レビューEvidenceへ昇格しない
この設計では、「Codexが止まったからレビューなし」「Claude Codeが空いているから自己レビューで代用」といった近道を許しません。
リスク分類の役割も変わりました。レビューの有無を決める用途より、必要な推論強度、対象範囲、追加のSecurity確認を決める用途へ寄せています。
この分業で得られたメリット
曖昧な要求を実装前に発見できる
実装指示書を作る過程で、主語、対象ユーザー、目的、非目標、完了条件の不足が表面化します。コードを書いた後に仕様を考えるより、修正範囲を抑えられます。
設計と実装の差分が記録に残る
「何を頼んだか」「実装上どの前提を変えたか」「どの検査を通したか」がMarkdownとGit差分に残ります。問題が起きたとき、会話の記憶ではなく記録を調べられます。
AIの自己承認を避けられる
設計、実装、評価を同じ会話で連続して行うと、AIは自分が採用した方針を前提に評価しやすくなります。別のコンテキストへ渡すことで、評価の入口を変えられます。
人間が品質判断へ参加しやすい
人間は、すべての実装を手作業で行わなくても、受け入れ条件、変更禁止範囲、リスク、レビュー指摘の採否を通じて品質を管理できます。
指示書が次回の学習資産になる
良い指示書は、その場限りのプロンプトではありません。失敗原因、正しい制約、確認コマンド、再発防止策を追記すれば、Claude CodeのCLAUDE.md、CodexのAGENTS.md、CI、品質ゲートへ移せます。
公開前に一度立ち止まれる
実装速度が上がると、作れたことと、公開してよいことを混同しやすくなります。独立監査を置くことで、公開判断を一度切り離せます。
実際に見えたデメリット
直列工程のため、受け渡しコストが大きい
ChatGPT、Claude Code、Codexが順番に同じ背景を読み直します。設計書が長くなるほど、実装者と監査者が必要な情報を探す負担も増えます。
複数AIを使うこと自体が効率化ではありません。各工程が前工程の成果を読み直す構成では、受け渡しの税(handoff tax)が発生します。
ChatGPTの設計が、リポジトリの現実とずれる
ChatGPTがコードベースを十分に確認していない状態で、ファイル構成や関数名まで指定すると、Claude Codeは誤った設計へ引っ張られます。
指示書の価値は詳細さでは決まりません。目的、制約、受け入れ条件、非目標が正確であることを優先します。
Codexのレビューが遅すぎる
完成直前に初めて独立レビューを入れると、アーキテクチャやデータモデルの問題が最後に見つかります。修正範囲が広い変更では、実装前または中間時点で設計上の論点だけを確認した方が合理的です。
機械検査で分かる問題までLLMへ渡してしまう
format、lint、typecheck、unit test、buildで判定できる問題をCodexへ読ませる必要はありません。長いログや生成物まで渡すと、コストが増え、重大な問題への注意も薄まります。
「別のAIが確認した」という誤った安心が生まれる
複数のAIが同じ結論へ到達しても、その結論が正しいとは限りません。同じ曖昧な要求を受け取れば、異なるAIでも同じ方向へ誤ることがあります。
レビューの信頼性は、AIの数ではなく、明確なGround Truth、最新の差分、根拠付きの指摘、権限分離、停止条件で決まります。
複数AIが同じブランチを触ると統合負債が生まれる
Claude CodeとCodexの双方が同じブランチを編集すると、変更の所有者が曖昧になります。
未コミット変更、worktree、mainブランチの状態を正しく把握できないまま作業が重なると、修正したはずの変更が戻る、別の差分が混ざる、同じ問題を再調査するといった事態が起きます。
AIが改善候補を出し続け、公開判断が遅れる
AIへ品質改善を頼むと、改善候補はほぼ無限に出てきます。「あと一つ直してから」を繰り返すと、公開阻害要因と公開後改善が混ざります。
品質検査が、公開を止める条件を判定する工程ではなく、不安を減らす儀式へ変わった時点で、運用設計を見直す必要があります。
Netsujoで実際に起きたこと
追加実装が画面全体へ広がった
既存の分析画面へ顧客ゴール欄を追加したいという要望が、改善指示を重ねるうちに画面全体の再設計へ広がったことがありました。
原因は、AIの能力不足よりも、こちらが「既存画面の構造は維持する」「今回変更するのは入力項目と分析への接続だけ」と明記していなかったことです。
曖昧な要望が高速で実装されました。
この経験から、Task Contractへnon_goalsとinvariantsを必須化する方針に改めました。
Claude CodeとCodexの変更が混ざった
Claude CodeとCodexの双方にGitHub上の修正を任せた結果、mainブランチと未コミット変更の状態把握が難しくなったことがありました。
原因は、担当領域、作業ブランチ、正本、統合責任者が未定義だったことです。
これを受け、次のルールを標準化対象にしています。
- 1タスク・1ブランチ
- mainへの直接変更禁止
- Codexは原則読み取り専用
- 実装修正はClaude Codeへ戻す
- merge、push、deployは人間の明示判断
- 同じhead SHAを二重レビューしない
Codexの品質検査コストが膨らんだ
広い範囲の品質調査を依頼すると、Codexはリポジトリ全体を再探索し、Claude Codeがすでに読んだコードも読み直します。
さらに、lintや型検査で判定できる問題、長い成功ログ、lockfile、生成物、差分外コードまで含めると、レビューの焦点がぼやけます。
このため、機械検査を先に通し、独立レビューには差分と契約違反の検出へ集中してもらいます。Reviewer Runtimeは固定せず、必要なRoleと現在のRuntime状態から選びます。
「比較しない」が一部の分析へ伝わっていなかった
Netsujo SIGNALの顧客向け分析画面では、対象期間と比較条件を指定できます。その中に「比較しない」という選択があります。期待する挙動は明確で、「比較しない」を選んだ場合はすべての分析セクションで前期間データを使わないことです。
Claude Codeの実装後、Task Contractと差分をCodexへ渡して照合したところ、次の状態が指摘されました。
- 一部のセクションでは「比較しない」が反映されていた
- 別のセクションには前期間の指定が渡り続けていた
- 画面は表示できた
- 型検査は通った
- 既存テストも通った
- buildも成功した
コードは壊れていません。利用者が選んだ条件と、一部の分析結果の意味が一致していませんでした。
この種の欠陥は型検査では見つけにくいものです。前期間を表す値の型が正しく、関数の引数として受け取れるなら、TypeScript上は問題になりません。既存テストが「データを取得できること」だけを確認していれば、「比較しない場合は全セクションで前期間を渡さない」という契約違反も通過します。
差分レビューで確認する対象は、構文ではなくデータの流れです。利用者の選択、比較条件の正規化、各分析セクションへの引き渡し、表示と集計という経路のどこかで適用が抜ければ、画面が動いても結果の意味が変わります。
この対応では、漏れていた適用箇所を直すだけで終わらせず、次を実装しました。
- 「比較しない」を選んだ場合の回帰テスト(
src/lib/signal-portal/analysis-filters.test.ts) - 分析条件の適用漏れを検査するスクリプト(
scripts/check-portal-gating.mjs) - 上記を
package.jsonとGitHub ActionsのCIへ接続
重要なのは、Codexが一度問題を指摘したことではありません。指摘を、次回から機械的に止められる検査へ変えたことです。
AIレビューのコメントだけを直して終えると、同じ欠陥が別のセクションで再発します。良い品質検査は、発見した欠陥をテスト、CI、プロジェクトルールへ移し、同じ問題で再び高価な推論を使わない状態を作ります。
検査へ移しても、その検査自体に穴が残る
ただし、検査へ移せば終わりではありません。上の検査スクリプトを追加したあと、別の差分レビューで、検査そのものの欠陥を指摘されました。
コメントを取り除く処理が、文字列リテラルの中にあるURLの//もコメントの開始として扱い、その行の以降を読み飛ばすという内容です。検査は問題なく動いているように見えても、特定の書き方をした行だけを黙って見逃します。見逃したことは、検査の実行結果には現れません。
検査を書いた本人は、その検査が拾えない範囲を想像しにくい状態にあります。テストも検査スクリプトも自分で書いている以上、穴のある場所にはそもそも検査が書かれていません。このため、実装だけでなく、検査スクリプト自体もレビュー対象に含めています。
CIが緑であることは、検査が意図したとおりに効いた証拠にはなりません。検査を足すたびに、その検査が何を拾えないかを別の目で確かめる必要があります。
割り当ては、ツール名ではなく権限・作業単位・受入条件で決める
ここまでツール名で工程を説明してきましたが、運用を続けるとこの書き方は扱いにくくなります。ツールは入れ替わりますし、同じツールでも与える権限によってできることが変わるからです。ツール名で役割を固定すると、ツールを変えた瞬間に運用の説明が全部書き直しになります。
現在は、次の3つで割り当てを決めています。
| 決める軸 | 内容 | 決めていないと起きること |
|---|---|---|
| 権限 | 読み取りだけか、ファイルを変更してよいか、commit・pushしてよいか、本番へ出してよいか | 「確認だけ」のつもりの担当が変更を加え、どの変更が誰のものか追えなくなる |
| 作業単位 | 1タスク・1ブランチ・1差分など、どこで区切って渡すか | 複数の担当が同じ範囲を同時に触り、統合の負債が生まれる |
| 受入条件 | 何をもって完了とするか。機械検査の結果、証拠の形、人間の承認 | 「完了しました」という報告が、何も保証しない言葉になる |
この3つで書くと、割り当て表からツール名を外せます。
| 役割 | 権限 | 作業単位 | 受入条件 |
|---|---|---|---|
| 設計・要求の整理 | 変更権限なし。読み取りと文書作成のみ | 1タスクにつき契約書1通 | 対象・非対象・完了条件が書かれていること |
| 実装 | リポジトリの変更、branchへのcommitとpush | 1タスク・1ブランチ | 機械検査(lint、型、テスト、build)がPASSしていること |
| 第三者レビュー | 読み取りのみ。実装・自動修正・commit・pushを禁止 | 差分限定のbundle 1件 | 指摘が渡した差分の範囲に収まっていること |
| 機械検査 | 判定のみ。可否を返すが何も変更しない | 1差分 | 決定的に再現すること |
| 公開判断 | 本番反映の実行権限 | 1リリース | 人間が対象・影響・公開日時を承認していること |
ツール名を書かなくても、この表だけで役割は成立します。実際にどのツールを当てるかは、その時点で権限と作業単位を満たせるものを選べばよく、この記事の前半で挙げた3つの組み合わせも、その一例にすぎません。
独立レビューを担当する人には、そのレビュー対象を変更する権限を持たせないことが要点です。 実装担当が原因を調査し、変更し、自分の変更をテストすることは必要です。ただし、その自己確認を独立レビューとして数えると、実装時の前提が誤っていても同じ前提のまま見逃すおそれがあります。
この表はNetsujoの現在の運用です。組織の規模、扱うデータ、リリース頻度によって適切な区切りは変わるため、すべての開発で有効な配分として書いているものではありません。
三つのAIを常時使う必要はない
現在の直列構成を、そのまますべての変更へ適用する必要はありません。
次の順序が合理的です。
- 人間が目的とリスクを定義する
- Task Contractを作成する
- Claude Codeがリポジトリを調査する
- 矛盾があれば実装前に報告する
- 1タスク・1ブランチで実装する
- 機械検査を実行する(format、lint、typecheck、関連テスト、必要時のみfull test、build)
- 変更リスクを分類する
- Claude Codeが修正する
- 機械検査を再実行する
- 必要時のみ焦点を絞った再レビューを1回行う
- 人間が公開判断を行う
7の分類は、レビューを呼ぶか呼ばないかの判断には使いません。分類の用途は推論強度の選択だけです。
リスク分類を「呼ぶ/呼ばない」に使うのをやめた
以前は、Lowリスクの変更では第三者レビューを呼ばず、Mediumは条件に該当したときだけ差分レビューを行う運用にしていました。推論資源をリスクに応じて配分する、という考え方です。
この運用には穴がありました。分類そのものが外れたとき、何も検出されません。 実際に、Lowとして分類された差分がレビューを経ずに統合され、あとから顧客へ事実と違う状態を出す欠陥が見つかりました。分類の精度を上げるという対処もありますが、分類が外れる可能性は残ります。外れたときに検出がゼロになる設計は、分類の改善では埋められません。
そこで、機械検査がPASSした差分は、内容にも大きさにもよらず第三者レビューを1回通す運用へ戻しました。大きい差分ほどレビューされない、という逆転を作らないためでもあります。
現在、レビューを呼ばないのは次の3つだけです。
- レビュー対象のテキスト差分が0件(画像だけの差し替えなど)
- 機械検査がFAIL、または未実施(先に直す。未実施はPASSではない)
- 自動レビューの回数上限を使い切った(以降は人間が判断する)
リスク分類は推論強度の選択に使う
| リスク | 変更例 | 分類の使いみち |
|---|---|---|
| High | 認証、権限、課金、DB migration、顧客データ、公開API、診断・スコアリングロジック、本番env・deploy | 推論強度を高くしてレビューする。実装前に設計論点も確認する |
| High以外 | 上記に該当しないすべて。文言、記事、CSS、ドキュメントを含む | 推論強度は中で、機械検査PASS後に1回レビューする |
ルールに一致しないファイルは、下の区分へ落とさず上の扱いにします。判断できないことを、安全だと読み替えないためです。
この構成では、AIの数でも変更の大きさでもなく、推論資源の強さをリスクに応じて配分します。レビューの有無そのものは配分の対象にしません。
巨大変更を一度にCodexへ渡すことも避けます。差分が大きすぎる場合は、Pull Requestまたは変更単位を分割します。
指示書は「詳細な命令書」から「検証可能な契約」へ変える
今後のMarkdown指示書では、最低限、次の項目を必須にします。
| 項目 | 記述する内容 |
|---|---|
| goal | 何を達成するか |
| user_value | 誰にどんな価値があるか |
| scope | 今回変更する範囲 |
| non_goals | 今回変更しない範囲 |
| invariants | 絶対に壊してはいけない条件 |
| acceptance_criteria | 完了を判定できる条件 |
| risk_level | low、medium、highのいずれか |
| test_plan | 実行する検査 |
| evidence | 完了報告に必要な証拠 |
| stop_conditions | 自動修正を止め、人間へ戻す条件 |
とくに重要なのは、non_goals、invariants、stop_conditionsです。
「顧客ゴール欄を追加する」という依頼で、既存分析画面を置き換えないのであれば、それを明記します。三回修正しても同じ失敗が続くなら、AIに続行させず人間へ戻します。PASSを得るためにテスト、型設定、セキュリティ設定を弱めることも禁止します。
AIの自己修正能力を高めるには、反復回数を増やすより、合格条件と停止条件を明確にする方が有効です。
独立レビューは「全体再調査」から「Exact HEADの差分レビュー」へ
独立Reviewerへ渡す中心情報は次へ絞ります。
- Task Contract
- base SHAとhead SHA
- 対象差分
- 関連する最小限のコード
- 機械検査の要約
- 重点的に見るリスク
- 重大な指摘だけを返す条件
避ける入力も決めています。
- リポジトリ全体の無制限な再探索
- 長大な成功ログ
- 生成物の無目的な全文
- 差分外のリファクタリング提案
- 同じExact HEADへの重複した有料レビュー
- Reviewerによる勝手なcommit、push、merge、deploy
指摘は重大度、対象path、破られた契約、影響、根拠、最小限の修正方針へ構造化します。
「該当する指摘がなかった」と「安全である」は同義ではありません。独立レビューは、テスト、CI、権限設計、本番受入を置き換えるものではありません。
内部Judgeと独立Reviewerを混同しない
実装Runtimeの内部にも、lint、typecheck、test、buildを実行するDeterministic Judgeや、変更内容を自己点検する役割を置けます。これらは実装ループを速くするために有効です。
ただし、同じ実装Assignmentの内部評価をIndependent Reviewへ昇格させません。
現在の役割は次のように分けています。
- Implementer:コード変更と修正
- Deterministic Judge:機械検査
- Self-check:実装側の論理確認
- Independent Reviewer:別Assignment・別権限でExact HEADを評価
- Controller / Human:Evidenceを統合し、停止・採用・公開を判断
機械で判定できる問題は機械へ寄せます。独立レビューは残します。Runtimeの選択だけを、現在の能力・権限・残容量・live capacityに応じて変えます。
本当に効果があるかを測る
「三つのAIを使うと品質が上がる」という感覚だけでは、運用を正当化できません。
少なくとも次を記録します。
- 実装開始から公開までのLead Time
- First-pass Success Rate
- 平均修正回数
- Codexの呼び出し回数
- 1レビューあたりのinput、output、total token
- 同一SHAへの重複レビュー数
- Codexが見つけた重大欠陥数
- そのうち回帰テストやCIへ移行できた欠陥数
- Codexの指摘が誤っていた件数
- 機械検査で先に検出できた問題数
- 公開後に発覚した不具合数
- rollback回数
- 人間が統合判断に使った時間
30日単位で、Reviewer Runtime、推論強度、レビュー入力、検出した重大欠陥、本番後不具合、人間の介入時間を比較します。
重大欠陥の検出や本番後品質が変わらず、推論コストだけが増えるなら、入力範囲や推論強度を調整します。レビュー要件そのものを消す判断とは分けます。
外部の事例も参考になります。OpenAIが2026年1月に公開したDatadogの事例では、過去にインシデントへつながったPull Requestを再現してCodexへレビューさせ、当該インシデントを担当したITエンジニアが「当時その指摘があれば違いがあった」と判断したケースが10件超、調査対象のおよそ22%だったと報告されています。これはOpenAIが公開した個別企業の事例であり、一般的な検出率を示すものではありません。一方、決定的なルールでは拾いにくいシステム全体の相互作用を追加のレビューで見るという使い方の妥当性は示しています。
測定しなければ、複数AIの分業は開発プロセスではなく信仰になります。
AIが増えても、人間の責任は分散しない
ChatGPT、Claude Code、Codexを並べても、三人のITエンジニアによるチームができるわけではありません。
それぞれは責任を負わない確率的な処理系です。目的が間違っていれば、間違った目的を精緻化します。受け入れ条件が弱ければ、見栄えの良い未完成をPASSと判断します。公開を止める人がいなければ、改善候補を出し続けます。
人間に残る仕事は次のとおりです。
- 何を作るかを決める
- 何を変えないかを決める
- どのリスクを許容するかを決める
- 指摘が仕様変更か不具合修正かを区別する
- どこで修正を止めるかを決める
- 公開後に責任を負う
AIエージェント時代の開発責任者は、コードを書く量が減る一方で、役割、権限、評価基準、停止条件を設計する仕事が増えます。
現在の運用原則
固定3AI分業は、少人数開発へ役割分離を持ち込む最初の仕組みとして機能しました。
そのまま規模を広げると、Runtimeごとの利用枠、同時実行、guard状態、handoff costが次の制約になります。
現在の標準は次の六点です。
- Task Contractで目的、非目標、受け入れ条件、停止条件を固定する
- RoleとRuntimeを分ける
- 実装RuntimeはCapability・Authority・fresh quota・live capacityから選ぶ
- 機械検査をLLMレビューより先に通す
- 独立レビュー要件はRuntimeの利用可否から独立させる
- 人間はモデルを手で選び続ける役から、目的・権限・資源配分・停止条件を設計する役へ移る
製品名やモデルは今後も変わります。残る資産は、誰がどのRoleを持ち、どのRuntimeがその仕事を実行でき、何をEvidenceとして次へ進み、利用可能な計算資源をどこへ配るかという運用設計です。
Netsujoでは、この考え方をAgent OSと自社プロダクトの継続開発で実装しています。詳細は生成AI導入支援・AI PoC・業務実装で確認できます。
よくある質問
ChatGPT・Claude Code・Codexの担当は固定しないのですか
固定Roleは持たせますが、Runtimeは固定しません。事業要求の整理ではChatGPTを使う場面が多く、実装ではClaude CodeやCodexが候補になります。最終的な実行先は必要能力、権限、残容量、live capacityなどの条件で決めます。
すべての変更を同じAIでレビューするのですか
同じRuntimeへ固定しません。レビュー可能なテキスト差分には独立レビュー要件を維持し、リスクや複雑さに応じて推論強度やReviewer Runtimeを変えます。機械検査がFAILしている場合は、その修正を先に行います。
異なるAIを使えば、レビューは独立しますか
製品名が違うだけでは足りません。実装AssignmentとReviewer Assignmentを分け、Exact HEADへEvidenceを結び、評価側の権限を制限します。同じ実装担当による自己確認はIndependent Reviewへ数えません。
残りトークンが多いAIを選べばよいですか
残容量は一つの入力です。Roleへの適格性、権限、live capacity、guard healthも確認します。2026年9月19日の実運用でも、Claude Codeは利用枠が残っていても別interactive sessionによってQC開始を見送り、Codexはguard状態を確認できず候補から外れました。
AI同士で自動修正を続ければ品質は上がりますか
反復回数を増やすだけでは、コストと誤修正も増えます。最大修正回数、同じ失敗が続いた場合の停止、予算上限、OUTCOME_UNCERTAIN、人間へのエスカレーション条件を先に定義します。
参考資料
- OpenAI Codex code review in GitHub
- OpenAI Custom instructions with AGENTS.md
- Anthropic Claude Code overview
- Anthropic Create custom subagents
- Anthropic Automate actions with hooks
- OpenAI Datadog uses Codex for system-level code review
外部製品仕様の記載は公開前に再確認します。NetsujoのRole/Runtime・quota policyに関する記述は2026年9月19日時点の実装を対象としています。
この記事の著者
飯田 友広
代表取締役
Netsujo株式会社 代表取締役。Technical BizDev / AI Deploymentとして、顧客の業務課題、AI適用領域、PoC、実装チームとの要件、本番導入後の評価をつなぐ。京都発のWeb3・AI実装スタートアップを2023年6月に創業。Webサイトを営業基盤として捉え、経営・営業・検索・生成AI・コンバージョン・計測を横断して課題と改善優先順位を整理する「Netsujo SIGNAL」を設計・運営。さらに、ChatGPT・Codex・Claude Codeを状態再構築、競合回避、独立QC、Exact-head検証、停止、復旧まで含む制御ループで運用する社内AI開発基盤「Netsujo Agent OS」を設計・実運転。Netsujoとして京都ビッグデータ活用プラットフォームに参画(小規模企業会員(ベンチャー))し、同プラットフォーム発のワーキンググループ「Chain Up KYOTO」にも参画(2026年3月10日〜)。IVS2026サイドイベント「なぜ京都でWeb3.0ビジネスなのか」はNetsujoとして京都府庁旧議場で主催・企画・登壇・運営(2026年7月2日/京都府 総合政策環境部 デジタル政策推進課は共催)。京都美術工芸大学・龍谷大学での講義に加え、京都高度技術研究所(ASTEM)、旅館業界、就労支援施設、Open Source Conference等で登壇実績。ITコミュニティ「みやこでIT」(connpassメンバー639名・イベント176件・2019年2月から運営)運営。NPO法人NEMTUS理事、BAR KRYPTO運営。Netsujoはソーシャル企業認証制度「S認証」の認証企業(2026年2月認証・2026年4月公表)。技術領域はWeb3/ブロックチェーン/DID/NFT/生成AI/コミュニティ運営。
プロフィールを見るこの記事が向いている方
複数のAIツールへ設計・実装・レビューを割り当てている経営者・事業責任者
複数Runtimeの残容量と独立レビューをどう配分するか決めたいITエンジニア
AI活用の品質ゲートと停止条件を、感覚ではなく運用設計として整えたい方
— 壁打ち相談
読者のよくある相談
記事を読んだ後に「自分の状況だとどう判断すべきか」を整理するための壁打ち相談を受け付けています。下記のような相談例が当てはまる方は、お気軽にご連絡ください。
Q. AIを何段も重ねているのに、手戻りとコストばかり増えている
機械検査で判定できる問題をLLMへ渡していないか、工程順を見直します。
Q. どのRuntimeへ実装や独立レビューを割り当てるべきか決まっていない
Roleの要件、Capability、Authority、残容量、live capacityを分けて判断します。
Q. 複数のAIが同じリポジトリを触り、mainの状態を把握できない
1タスク・1ブランチとし、監査担当は読み取り専用へ固定します。
上記いずれかが該当する場合、初回30分の壁打ち相談で論点整理に対応します。記事に書ききれない個別事情を踏まえた判断材料が必要な段階こそ、壁打ちが活きやすいフェーズです。
AI導入・PoC・業務実装のご相談
AIのRoleとRuntimeを、運用設計から決める
企画から運用定着まで、AIをどの工程へ入れ、どこで人間が判断するかを含めて設計します。構想段階でのご相談も可能です。