
AI開発・実運用
AI開発を半年回して分かった。PR数より「本番で検証済みになるまで」を測る
Claude Code 540セッション、merge済みPR 1,764件。その先で、PRODUCTION_VERIFIEDまでのdelivery速度とREADYという完了条件を分けて測る必要が見えてきた。
著者:飯田 友広(Tomohiro Iida)
この記事の結論
1,764件のmerge済みPRは生産能力の証拠であり、顧客価値や売上の証拠ではありません。
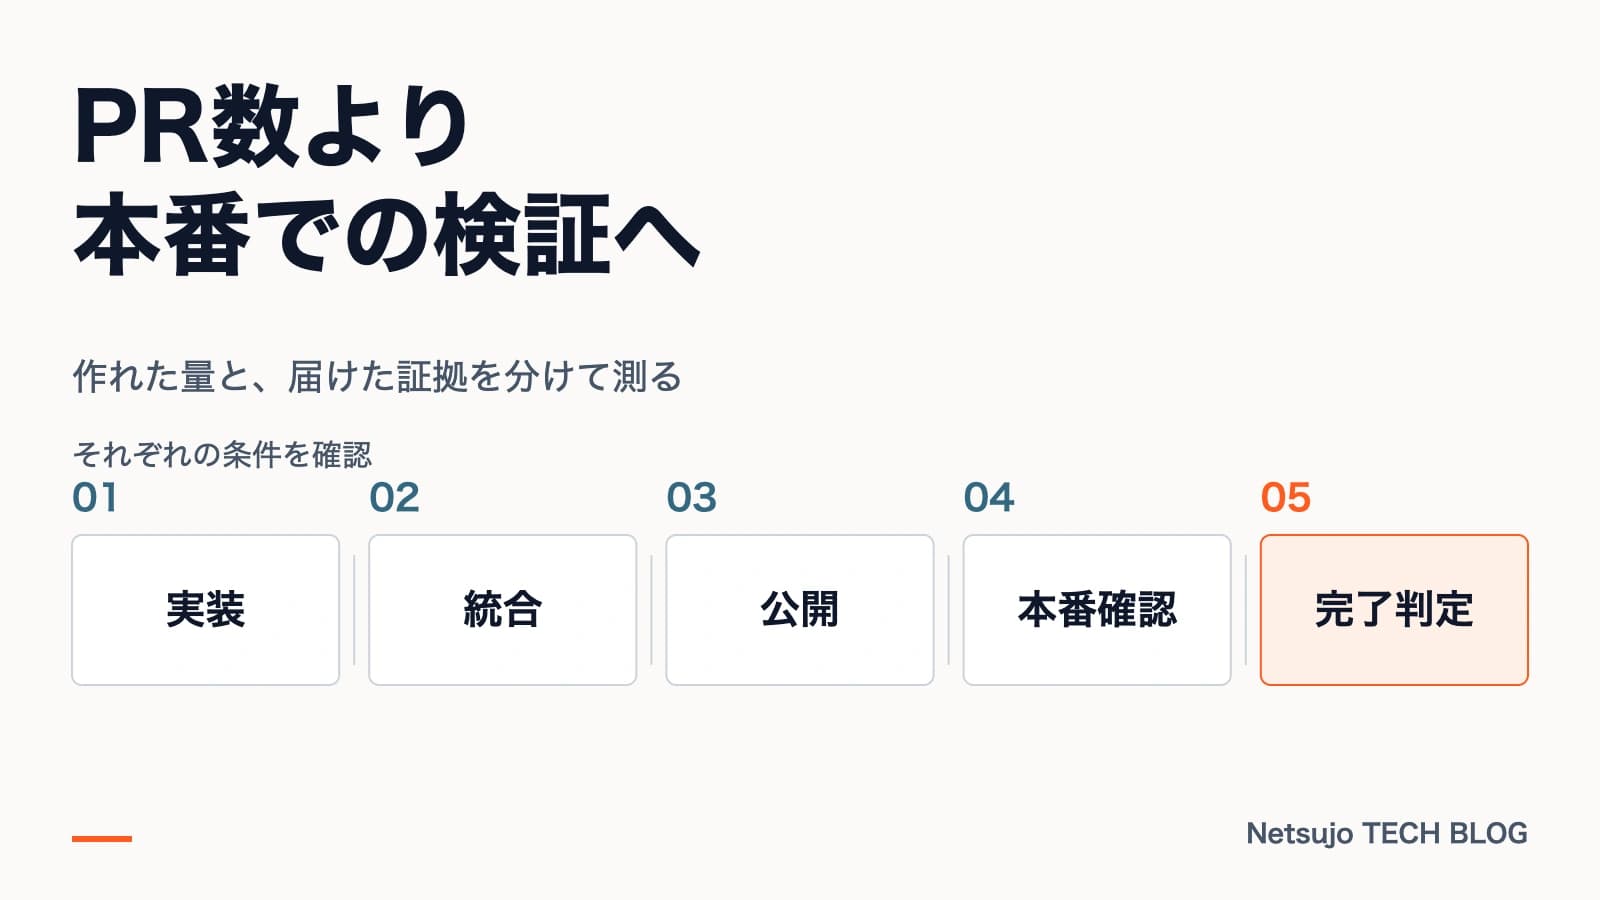
IMPLEMENTED、MERGED、DEPLOYED、PRODUCTION_VERIFIED、READYを分け、READYだけを真の完了状態とします。
次のdelivery KPIとしてTime to Verified Productionを計測します。これはREADYとは別で、historical medianやp95はまだ掲載しません。
Production verificationはdelivery計測の終点、READYはガバナンス上の完了であり、顧客価値・売上・継続率はさらに別の経済成果として測ります。
AIコーディングエージェントを大量に使えば、少人数の会社でも大きな開発組織に近い生産量を出せるのか。
私たちの約半年の実運用では、少なくとも「作れる量」は大きく増えました。2026年9月7日時点で、Claude Codeの作業記録は540セッション、Netsujo系8リポジトリのmerge済みPull Requestは1,764件、自作のSkillsは43本、専門Subagentsは26本、主力リポジトリのGitHub Actions workflowは49本です。
しかし、この数字をそのまま成功と呼ぶのは間違いです。
1,764件のmerge済みPRは、生産能力の証拠です。顧客価値、Product-Market Fit、売上、継続利用の証拠ではありません。
AIで大量に作れるようになると、価値のあるものだけでなく、不要なもの、誤ったもの、似た仕組み、過剰な検査も高速で増やせます。実装速度が上がるほど、「何を作るか」「誰が止めるか」「何を証拠に完了とするか」の設計が重要になります。
公開範囲は、自社で実測できた情報に限定します。顧客企業名、受託案件の詳細、未公開R&Dの固有名詞は伏せます。焦点は、生産量が増えたあとに、何を成果と呼び直したかです。
結論:AIで大量に作れることは、競争優位の一歩手前である
AIコーディングで得られるものは、まず生産能力です。
- 調査できる量が増える
- 実装できる量が増える
- テストや文書化を並行できる
- 複数の仮説を短い周期で試せる
- 一人または少人数でも、専門役割を分けやすくなる
これらは実際に価値があります。問題は、その先です。
生産能力が事業成果になるには、少なくとも二つの変換が必要です。
- 生産能力を、再現できる統制能力へ変える
- その能力を、顧客の行動変化や売上へ変える
前者を飛ばすと、AIが速く作るほど事故も増えます。後者を飛ばすと、高性能な開発組織を作っただけで事業は伸びません。
私たちが2026年後半に直面したのは、この二つの変換でした。
約半年で何が増えたのか
2026年9月7日に、リポジトリ、GitHub API、作業ログ、公開サイトから数値を取り直しました。
| 指標 | 実測値 | 何を示すか |
|---|---|---|
| Claude Code作業セッション | 540 | AI実装環境を継続利用した規模 |
| 作業ディレクトリ | 122 | 扱った作業面の広がり |
| 8リポジトリのmerge済みPR | 1,764 | 統合まで進んだ変更量 |
| 本番稼働を確認したサイト・プロダクト | 5 | 実装だけでなく公開運用した対象 |
| Skills | 43 | AIへ再利用可能な手順として残した数 |
| 専門Subagents | 26 | 専門レビュー・実行役の定義数 |
| 自動Hooks | 9 | AIの判断に頼らず機械的に止める経路 |
| GitHub Actions workflow | 49 | CI・品質検査・運用自動化の規模 |
主力リポジトリだけを見ると、2026年3月27日から8月30日までに1,564コミット、merge済みPR 1,391件でした。
これだけを見ると「AIで少人数開発を大幅にスケールできた」と言えそうです。実際、生産能力が増えたこと自体は否定しません。
ただし、この表には売上がありません。利用者数もありません。継続率もありません。2026年9月7日時点では、AI利用コストやCIの成功率・実行時間も統一した方法で集計できていません。
だから、ここで言えるのは大量に作れる体制を構築したまでです。「それによって事業が成功した」とは言えません。
3〜5月:最初に増えたのは、作れる量だった
3月末から、Webサイト、CMS、分析、SEO、業務自動化など、実際のリポジトリをClaude Codeで触る範囲が広がりました。
初期に学んだのは、AIへ詳細な命令を増やすことより、作業境界を決めることの重要性でした。現状を監査し、保持するものと変えるものを分け、実装後に検証する。この順番を崩すと、AIは誤った前提も高速で実装します。
この段階では、AIの価値を主に「実装量の増加」として見ていました。
それ自体は自然です。人間が数時間かけていた調査、コード修正、テスト、文書化を並行できれば、生産量は目に見えて増えるからです。
問題は、作れる量が増えると、判断しなければならない量も増えることでした。
6〜7月:AIを開発ツールから事業運用へ広げた
6月以降、AIの利用対象をコード変更だけに置かず、公開サイトの継続改善、計測、情報管理、品質ゲート、業務フローへ広げました。自社で改善していたWeb運用も、外部へ提供できるサービス構造へ整理しました。
この時期に変わったのは、「AIが何を作れるか」より「AIが作ったものを、どう事業の正しい情報と結びつけるか」という問いです。
料金、プラン、問い合わせ先、計測ID、公開URL、構造化データ。事業情報はページ本文だけに存在するわけではありません。フォーム、メール、決済、JSON-LD、記事、CTAへ波及します。
一つを直しても別の場所に古い値が残れば、AIが速いほど不整合を増やします。
そこで、正準情報、判断記録、回帰テスト、変更禁止範囲を明示し、「長いプロンプトを覚えさせる」より「間違えたときに機械的に止まる」方向へ寄せました。
ここで初めて、AI活用の中心が開発テクニックから運用設計へ移りました。
8月:AIを増やすだけでは組織にならなかった
8月には、AI用のSkills、専門Subagents、Hooks、レビュー役、運用規程がかなり増えていました。
ところが、実際の作業ログを777件集計すると、汎用エージェントが70.1%を占め、用意した専門エージェントのうち複数は使用回数0でした。
専門家役を定義しただけでは、専門家が働く組織にはなりません。
原因は単純で、ルーティング表に書いた役職名と、実際に呼び出せるエージェント識別子が接続されていませんでした。設計図には部署があるのに、仕事がそこへ配送されていなかったのです。
実行担当を追加して接続し、偏り自体を定点観測する対象へ変えました。
この失敗から得た教訓は、AIエージェントの組織図も、コードと同じように実測しなければならないということです。
「専門エージェントを26本作った」は資産数です。「必要な仕事が適切な役割へ流れた」は運用成果です。この二つを分けないと、エージェント数だけが増えます。
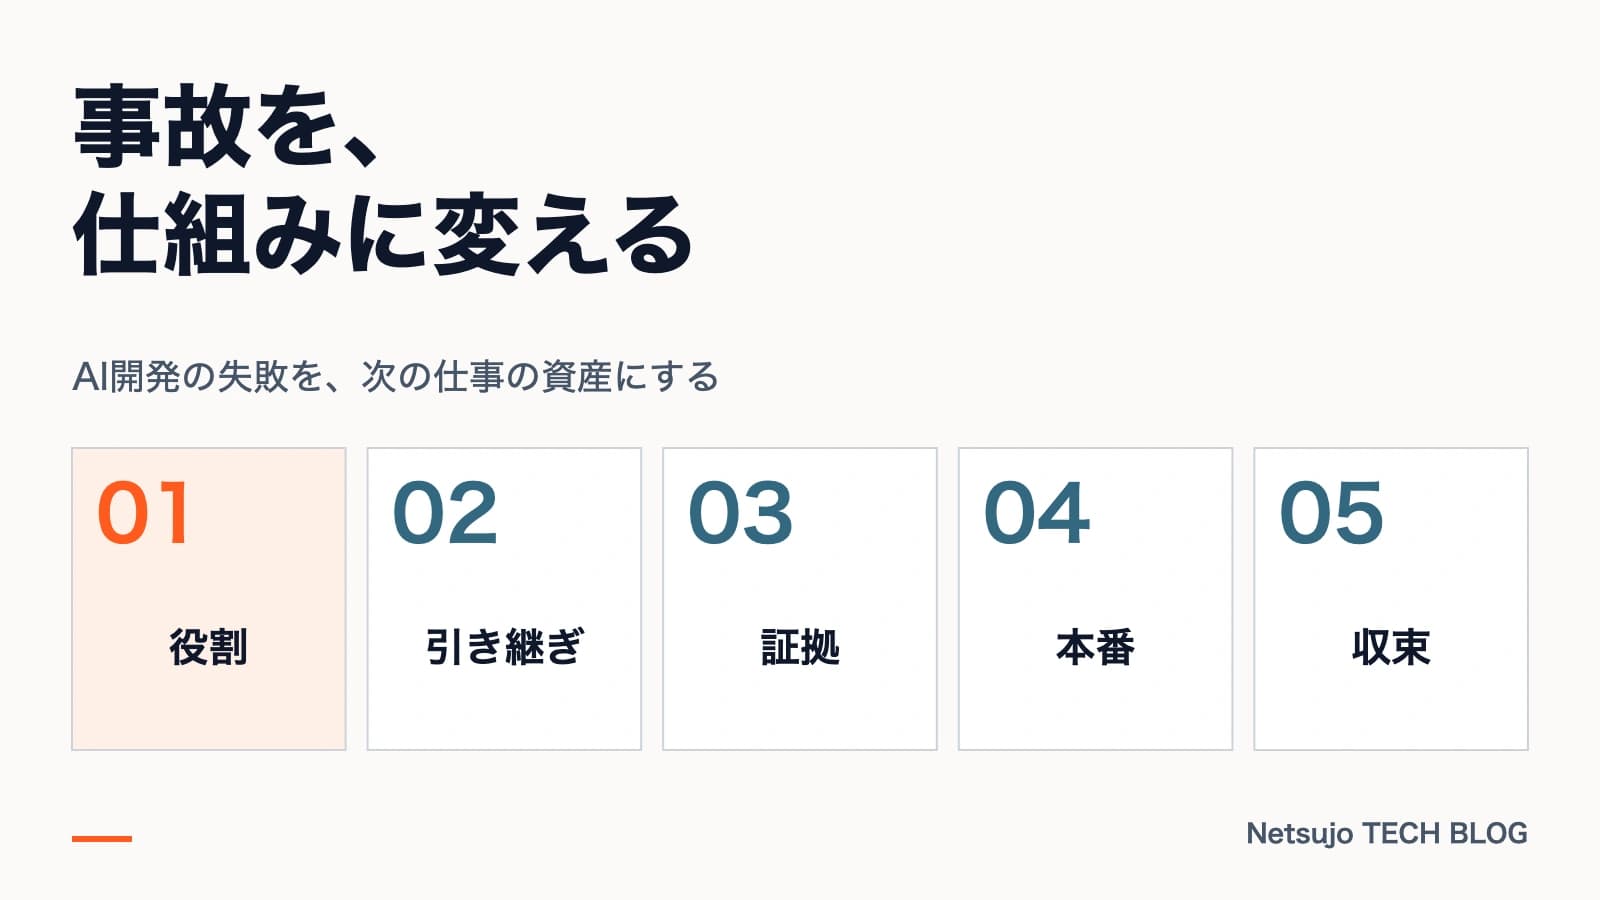
失敗を「仕組み」で止めるようにした
AIに同じ注意を何度も伝える運用は、人間の監督労働を増やします。
私たちは、差し戻しや事故を記録し、可能なものを実行可能な検査へ変えるようにしました。2026年9月7日時点で、失敗事例アーカイブは20件、そこから生まれた検査資産の登録は17件です。
典型的な変換は次のようなものです。
- 「この変更はしてはいけない」→ CIやHookで禁止する
- 「同じ差分を二重に確認しない」→ commit SHAを証拠のキーにする
- 「テストが通ったと言った」→ 実行結果と対象SHAを一緒に保存する
- 「mainへ入った」→ Productionへ出た証拠とは分ける
- 「AIが確認した」→ 実装者の自己確認と独立した評価を区別する
- 「前にも注意した」→ 再発したら検査か停止条件へ昇格する
この発想を一言で表すと、Context Is Not Enforcementです。
プロンプト、Markdown、会話履歴にルールを書いても、それだけでは強制になりません。AIが読まない経路、古い文脈を使う経路、並行作業で別の状態を見る経路が残ります。
重要な制約ほど、文章からコードへ移す必要があります。
個々の事故と実装方法はAIエージェント開発・運用の事故録に分けて記録しています。ここで評価するのは、事故を再利用可能な統制へ変えたことです。
作れたことと、公開してよいことを分けた
AIで実装速度が上がると、「できた」と「公開してよい」が混ざりやすくなります。
実際、一時期はChatGPTで要求を整理し、Claude Codeで実装し、Codexを別文脈の監査役として使う分業も試しました。役割分離そのものには価値がありましたが、同じ背景を複数AIが読み直す受け渡しコストや、レビューのためのレビューが増える問題も出ました。
詳細な使い分けはChatGPT・Claude Code・Codexの分業開発に譲ります。
特定のモデルを常時並べること自体を目的にはしません。
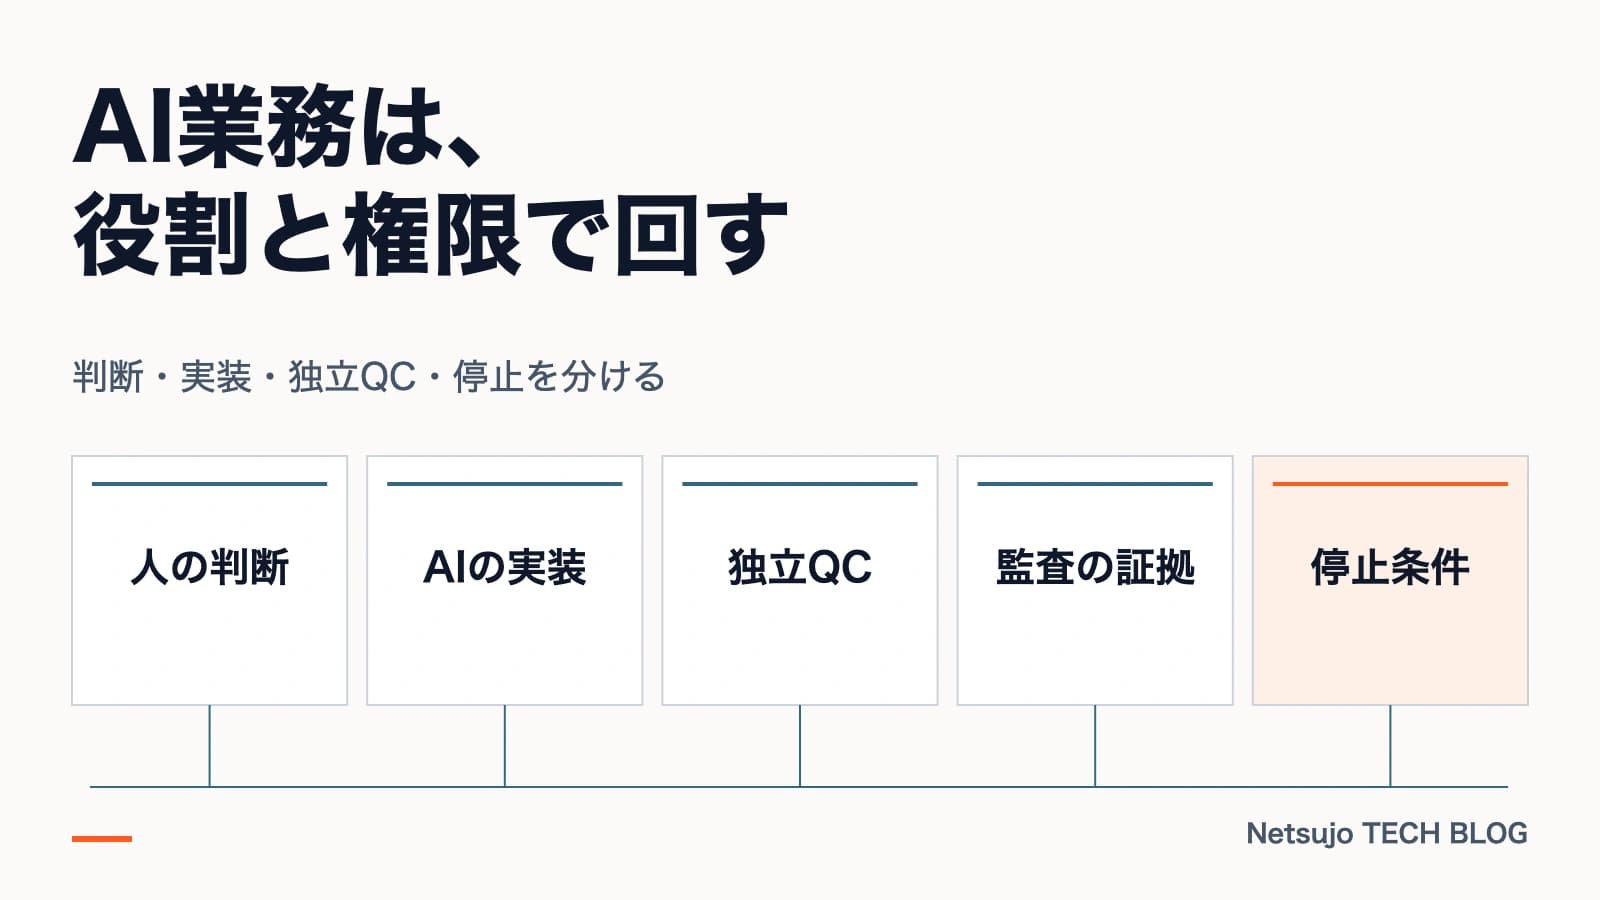
- 機械で決められることは機械で決める
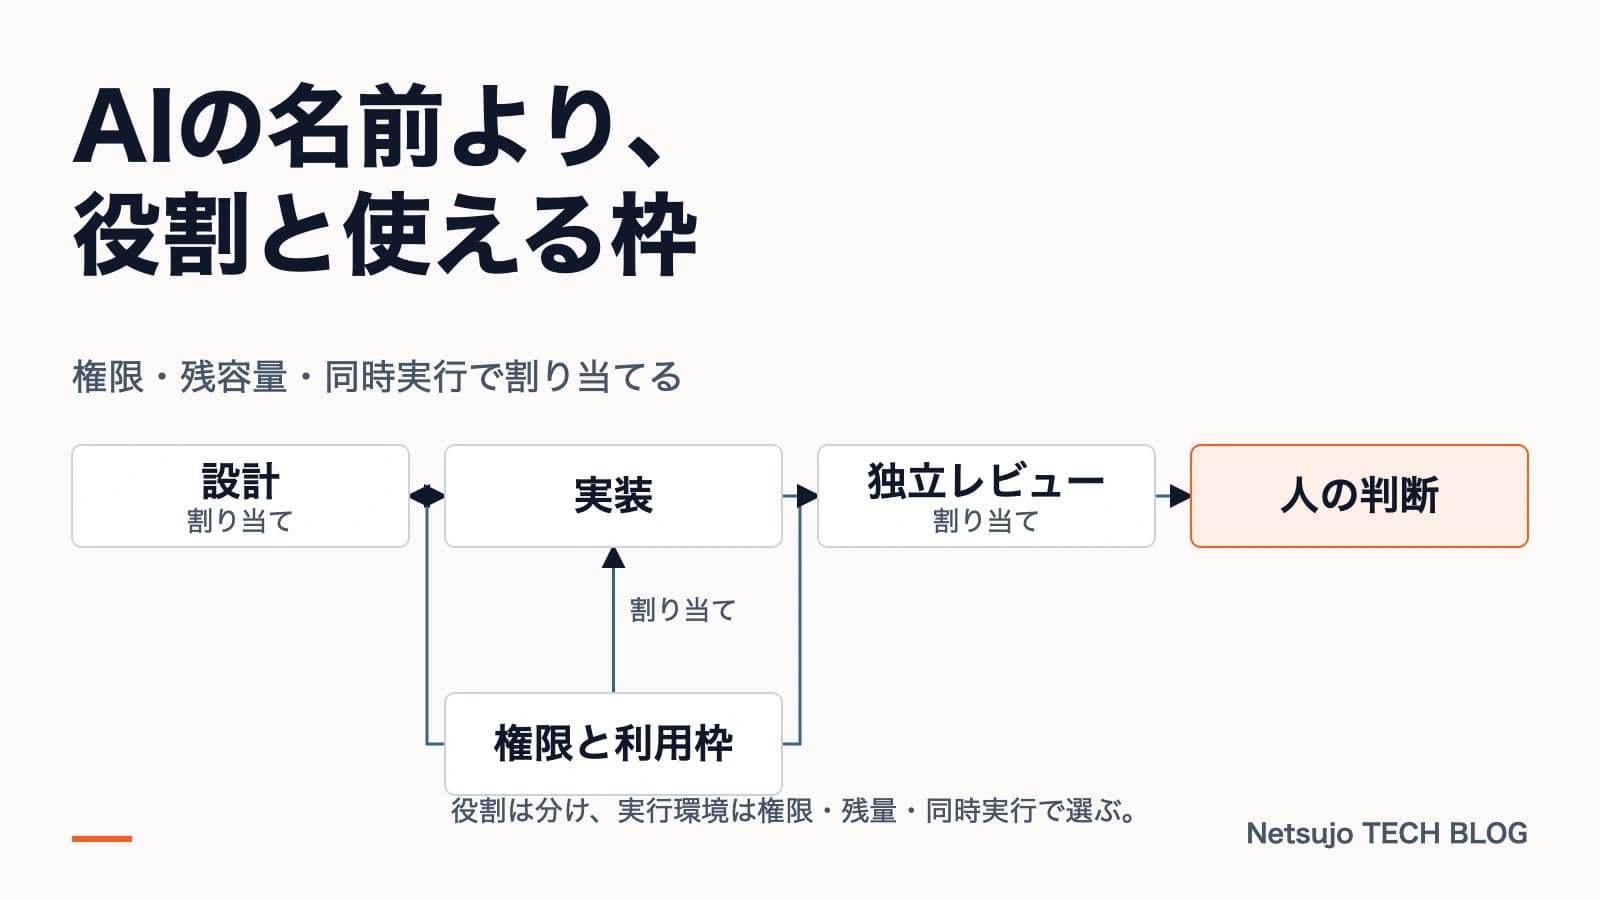
- 実装と評価の権限を分ける
- 合格の証拠を対象SHAへ結びつける
- 本番反映は別の判断として扱う
- 停止条件を先に決める
- 人間が公開責任を持つ
また、数値・固有名詞・断定表現を別エンジンで突き合わせる第三者チェック層も構築しましたが、この層は2026年8月21日以降、方針として停止しています。停止中の仕組みは「現在も常時稼働している品質保証」には数えません。
現在地を過大に見せないことも、AI運用のガバナンスの一部です。
8月末:巨大化したものを分けた
8月30日には、巨大化した単一リポジトリを、公開面、自社SaaS本体、ジョブ実行基盤という3つの責務へ分割しました。
ここで重要だったのは、ファイルを別の場所へ移したことではありません。責務間の境界を、暗黙の共有コードから検証可能な契約へ変えたことです。
契約ID、version、生成元commit SHA、payload hash、必須キーが一致しなければ停止する。公開面がSaaS本体の内部コードを直接読み込まない。mainへmergeされても、自動でProductionへ出ない。
速度を上げたあとに、境界を作り直す必要が生まれました。
9月:新しく作るより、収束させる仕事が増えた
9月に入ると、課題は「もっと作れるか」から「今あるものを安全に収束できるか」へ移りました。
exact SHAで検証対象を固定する。CIが通ったSHAとmergeするSHAを一致させる。deploy workflowの成功とProductionの実状態を分ける。認証、権限、課金、テナント境界を監査する。
これは開発速度が落ちたのではありません。大量に作れるようになった結果、統合責任と証拠管理がボトルネックとして表面化したということです。
AIがコードを書く時間を短くしても、どの変更を採用し、どこで止め、何を本番へ出すかという責任は消えません。
むしろ、AIが作れる候補を増やすほど、人間が捨てる判断の重要性は上がります。
mergeの先までを、別の状態として測る
2026年9月時点の運用では、実装、merge、deploy、本番検証を一つのPASSへ潰さないようにしています。
| 状態 | 何が確認できたか | 位置づけ |
|---|---|---|
| IMPLEMENTED | 実装候補と必要な検査が揃った | まだ |
| MERGED | 採用した変更がmainへ統合された | まだ |
| DEPLOYED | 対象commitのproduction向けdeploymentが成功した | まだ |
| PRODUCTION_VERIFIED | Production identityと必要なlive checkが、採用した対象と一致した | delivery計測の終点 |
| READY | 必要なinvariantとblocker条件まで満たし、ガバナンス上の完了として扱える | 真の完了 |
deploy workflowが成功してもProduction verificationが欠けていればREADYには進めません。さらに、PRODUCTION_VERIFIED自体もREADYと同義ではありません。現行のController契約では、READYだけを真の完了状態として扱います。
この分離が必要になった理由は、deploymentが存在することと、現在のProductionがそのdeploymentを配信していることが同じ観測ではないからです。
実際のSITE deploy経路をレビューすると、public aliasをdeployment identityとして扱う境界では、production向けcandidateと現在promoteされているProduction targetを安全に区別できない可能性がありました。
そこで、deployment identityの正本をVercel ProjectのProduction targetへ変更し、public aliasはHTTP・redirect・sitemapなどのlive acceptanceに使うよう分離しました。修正PRのexact-head hosted acceptanceは成功し、そのPRからProduction mutationは行っていません。
この修正から確認できたのは、deployment candidateの存在、deployment成功、promoteされたProduction identity、本番でのlive verificationは別の証拠だということです。
次に測るKPI:Time to Verified Production
PR数とmerge数は、作れる量を見るには役立ちます。ただし、merge後のdeploy待ちや本番確認待ちが長ければ、未完了の仕事が見えなくなります。
そこで次のdelivery KPIとして Time to Verified Production を計測対象にします。これはPRODUCTION_VERIFIEDまでの到達速度を測る指標であり、READYそのものを完了時間へ言い換えるものではありません。
- 開始:accepted workがactive implementationへ入った時点、または事前に固定したtask start
- 終了:Production identityが採用対象と一致し、必要なlive checkが完了した時点
- 中間点:implementation ready、exact-head CI、independent review、merge、deployment開始・成功、production verification
この指標のhistorical medianやp95は、2026年9月20日時点ではまだ集計していません。統一timestampが揃っていない工程もあるため、数値を後付けで推定しません。
この指標が短くても、READYを妨げるblockerが残るなら仕事は完了していません。
速度改善で削る対象は品質ゲートではなく、待ち時間、手戻り、曖昧なhandoff、再検証の重複、deploy後のidentity確認にかかる無駄です。
証明できたこと
約半年の運用から、少なくとも三つは証明できました。
1. 一人・少人数でも実装能力は大きく増幅できる
540セッション、1,764 merge済みPRという量は、それ自体が売上ではありません。しかし、従来なら手が回らなかった調査、実装、検証、文書化、運用自動化を同時に進められることは実証できました。
2. AI運用そのものを再利用可能な資産へ変えられる
43 Skills、26 Subagents、9 Hooks、17検査資産は、単発のプロンプトを次の作業でも再利用できる運用資産へ変えたものです。
価値は数そのものより、「同じ失敗に同じ人間の注意を使わない」方向へ移せることにあります。
3. AIチームも計測しないと形骸化する
777件のログを見なければ、70.1%が汎用エージェントへ偏っていたことも、使われていない専門役割も把握できませんでした。
AIエージェントは、設定ファイルを作った時点では組織ではありません。仕事が正しく流れ、期待した成果を返しているかを測って初めて運用になります。
まだ証明できていないこと
一方で、次はまだ証明できていません。
- AI開発によって売上がどれだけ増えたか
- 各プロダクトの利用者数や継続率がどれだけ改善したか
- AI利用コストを含めたROIが従来開発より高いか
- CIの成功率や実行時間が長期的にどう変化したか
- merge済みPR数と顧客満足の間に相関があるか
ここを曖昧にしたまま「AIで開発生産性が何倍になった」と言うつもりはありません。
開発量が増えたことと、会社の価値が増えたことは別です。
R&Dも同じです。実装済みの画面、データモデル、CLI、研究コードがあっても、利用者、導入、収益化が確認できなければ、事業成果としては扱いません。
KPIをPR数からdelivery速度・完了条件・顧客成果へ広げる
今後の評価は、五つのレイヤーに分けて見ます。
| 層 | 見る指標 | 意味 |
|---|---|---|
| 生産能力 | PR数、Lead Time、First-pass Success、修正回数、検査自動化率 | どれだけ速く再現可能に作れるか |
| delivery速度 | Time to Verified Production、工程別待ち時間、deploy/readback差し戻し | 作った変更をProduction verificationまでどれだけ速く運べるか |
| 完了条件 | READY、未解決blocker、required invariant | ガバナンス上、本当に完了と扱えるか |
| 統制能力 | 公開後欠陥、rollback、同一事故の再発、Evidence欠落、人間介入時間 | 速さを壊れない運用へ変えられているか |
| 経済成果 | 有効問い合わせ、商談化率、有料化率、MRR、継続率、顧客側の成果 | 作る能力を事業価値へ変えられているか |
PR数やコミット数を捨てる必要はありません。それらは生産能力を観測する有用な補助指標です。
一方、delivery計測の終点にはProduction verificationがあり、ガバナンス上の完了にはREADYがあります。その先に経済成果があります。AI開発基盤への追加投資は、delivery時間を縮め、READYまで安全に収束し、最終的に顧客成果へつながるかで判断します。
経営者が次にやるべきこと
AIコーディングを既に使っている会社なら、次にやることはエージェントを増やすことではありません。
1. 「作った量」「delivery速度」「READY」「顧客成果」を別のレイヤーで見る
PR、コミット、AIセッション、テスト数は能力指標として残します。Time to Verified Productionはdelivery到達速度として、READYは真の完了条件として別に追い、問い合わせ、商談、有料化、継続、顧客成果とも混ぜません。
2. 同じ注意が二度出たら、仕組みの欠陥として扱う
二度目の注意は、プロンプト改善の依頼で終わらせず、テスト、CI、Hook、権限、契約、停止条件のどこへ移すべきか検討します。
3. AIの役割より先に権限を決める
「レビュー担当」「実装担当」という名前より、読み取りだけか、変更できるか、commitできるか、本番へ出せるかを先に決めます。
4. 完了条件をEvidenceへ結びつける
「テストは通りました」「本番反映しました」という報告だけで終えず、対象commit、CI run、deployment、live URLなど、後から検証できる証拠を完了条件にします。
5. R&Dを増やす条件と止める条件を決める
AIで作れるからという理由で新しいプロダクトを増やさない。既存の生産能力を顧客価値へ変換できていないなら、次の実装より販売、導入、計測、継続改善へ資源を移します。
次に見るべき数字
約半年のAI開発運用で、少人数でも大きな実装量を扱えることは確認できました。
しかし、一番大きな学びは「AIが大量にコードを書けるようになった」ことではありません。
AIが増えるほど、判断、権限、Evidence、停止条件が重要になったことです。
そして、それでもまだ事業成果は別に証明しなければなりません。
開発運用で次に増やすべき観測は、PR数ではなく、accepted workがどれだけの時間でPRODUCTION_VERIFIEDへ到達したかです。その後、READYへ進めたかも別に確認します。
ただし、それも経営成果ではありません。顧客が使った、相談が増えた、有料化した、継続した、成果が出た。その数字は別に追います。
AIで一人会社の生産能力を組織規模へ近づけることはできます。次の課題は、その能力を安全に本番へ届け、さらに経済成果へ変換できる経営になっているかです。
---
データ範囲について:実測値は2026年9月7日時点です。2026年1〜2月は3月以降と同じ粒度の作業ログ・リポジトリ証拠が揃っていないため、詳細な時系列評価から外しました。顧客企業名、受託案件詳細、顧客データ、未公開R&Dは掲載していません。AI利用コスト、CI成功率・実行時間、各プロダクトの利用者数・売上は未集計であり、本記事の成果数値には含めていません。
この記事の著者
飯田 友広
代表取締役
Netsujo株式会社 代表取締役。Technical BizDev / AI Deploymentとして、顧客の業務課題、AI適用領域、PoC、実装チームとの要件、本番導入後の評価をつなぐ。京都発のWeb3・AI実装スタートアップを2023年6月に創業。Webサイトを営業基盤として捉え、経営・営業・検索・生成AI・コンバージョン・計測を横断して課題と改善優先順位を整理する「Netsujo SIGNAL」を設計・運営。さらに、ChatGPT・Codex・Claude Codeを状態再構築、競合回避、独立QC、Exact-head検証、停止、復旧まで含む制御ループで運用する社内AI開発基盤「Netsujo Agent OS」を設計・実運転。Netsujoとして京都ビッグデータ活用プラットフォームに参画(小規模企業会員(ベンチャー))し、同プラットフォーム発のワーキンググループ「Chain Up KYOTO」にも参画(2026年3月10日〜)。IVS2026サイドイベント「なぜ京都でWeb3.0ビジネスなのか」はNetsujoとして京都府庁旧議場で主催・企画・登壇・運営(2026年7月2日/京都府 総合政策環境部 デジタル政策推進課は共催)。京都美術工芸大学・龍谷大学での講義に加え、京都高度技術研究所(ASTEM)、旅館業界、就労支援施設、Open Source Conference等で登壇実績。ITコミュニティ「みやこでIT」(connpassメンバー639名・イベント176件・2019年2月から運営)運営。NPO法人NEMTUS理事、BAR KRYPTO運営。Netsujoはソーシャル企業認証制度「S認証」の認証企業(2026年2月認証・2026年4月公表)。技術領域はWeb3/ブロックチェーン/DID/NFT/生成AI/コミュニティ運営。
プロフィールを見るこの記事が向いている方
AIコーディングで実装量は増えたが、経営成果とのつながりを評価できていない経営者・事業責任者
複数のAIエージェントを使い、品質・権限・停止条件を運用として整えたい開発責任者
AI開発のKPIをPR数だけでなく、Production verificationまでのdelivery速度、READY、顧客成果へ分けたい方
— 壁打ち相談
読者のよくある相談
記事を読んだ後に「自分の状況だとどう判断すべきか」を整理するための壁打ち相談を受け付けています。下記のような相談例が当てはまる方は、お気軽にご連絡ください。
Q. AIで大量に実装できるようになったが、本当に成果が出ているか分からない
生産能力・統制能力・経済成果を別の層に分け、同じ数字で評価しないようにします。
Q. AIへ同じ注意を何度も繰り返している
二度目の注意を、テスト・CI・Hook・権限・停止条件へ移せないか検討します。
Q. 専門エージェントを増やしたのに、期待した分業になっていない
定義数ではなく実行ログを取り、どの役割へ実際に仕事が流れたかを確認します。
上記いずれかが該当する場合、初回30分の壁打ち相談で論点整理に対応します。記事に書ききれない個別事情を踏まえた判断材料が必要な段階こそ、壁打ちが活きやすいフェーズです。
AI導入・開発運用のご相談
AIの生産能力を、運用と事業成果へつなげる
PoCだけで終わらせず、役割・権限・品質ゲート・運用KPIまで含めて設計します。