
AI開発
GitHub Actionsを減らしたら、品質が落ちると思っていた。実際には逆だった。
AIエージェント時代のCIを、 9分31秒から2分09秒へ
公開日:2026年8月19日 更新日:2026年9月23日 著者:飯田 友広(Tomohiro Iida)
この記事の結論
AIエージェントでcommitとpushが増えると、CIの実行回数と重複そのものがボトルネックになります。
docs-onlyの実PRでは通常CIを9分31秒から2分09秒へ短縮し、経過時間を77.4%削減しました。
削減対象は、Draft中の重複、不要な実行基盤、同じ目的の二重検査です。品質ゲートそのものは残します。
UNKNOWNはfull pathへ倒し、skipした検査はPASS扱いせず、Final Candidateでexact-SHAの証拠を揃えます。
Controllerやcron、post-mergeまでイベント連鎖を監査し、起動しても状態を変えられないrunnerも止めました。
AIエージェントがworkflowまで編集する環境では、token・secret・未信頼入力・deploy権限をCIの品質設計と同じ境界で管理します。
CI品質はrunner minutesで測らず、現在の変更に対して必要な欠陥を確実に止められるかで評価します。
GitHub Actionsを減らす話が出たとき、私は少し怖かった。
CIは多いほど安全だと思っていたからです。
lint、typecheck、全テスト、ブラウザテスト、データベース検査、セキュリティ確認、本番ビルド。変更のたびに全部走らせれば、見落としは減る。少なくとも、そう考えていました。
ところが、Claude CodeやCodexを使って開発速度を上げると、別の問題が起きました。
AIは人間より短い間隔でcommitし、pushし、Pull Requestを更新します。一つの修正に対して、途中経過のcommit、レビュー修正、テスト修正、再レビューが次々に入り、そのたびにGitHub Actionsが起動します。
気づけば、コードより先にCIが詰まっていました。
それでも最初は、品質のための待ち時間だから仕方がないと思っていました。
しかし調べると、実際には同じ検査を重複して走らせ、古いSHAの結果を量産し、必要な失敗を見つけにくくしていました。
検査を増やしたことで、品質が上がるどころか、証拠が濁っていた。
そこでGitHub Actionsを減らしました。
正確には、検査そのものを捨てたのではありません。
必要のないタイミング、必要のない変更、同じ目的の重複実行を止めた。
結果として、docs-onlyの実PRでは9分31秒かかっていた通常CIが2分09秒になりました。77.4%の短縮です。
結果として、品質ゲートを薄くせず、何を確認したのかが以前より明確になりました。
CIが多いほど安心するという思い込み
CIがGREENになると安心します。
ただ、GREENという色だけを見るようになると危険です。
見るべきなのは、何を検査したのか、どのSHAを検査したのか、本番と同じ条件なのか、失敗しても握りつぶされる経路がないか、そして現在の変更と関係のある検査なのかです。
私たちの環境では、AIエージェントはGitHub Actionsを使いすぎる状態になっていました。
通常CIとexact-head検証が同じ重いsuiteを走らせ、docs-onlyでもPostgresが起動し、browserが不要でもChromiumを導入していました。さらに、変更内容を分類する頃にはnpm ciまで終わっていました。
これは安全というより、全員を毎回同じ検査場へ通している状態でした。
AIが速くなると、CIの前提が壊れる
人間が数時間に一度pushする開発では、毎回広い検査をしても実行回数は限られます。
AIエージェントは違います。
Builder A → commit → push
Builder B → commit → push
Builder C → commit → push
レビュー修正 → commit → push
テスト修正 → commit → push
実装能力が増えれば、CIへ流れ込むイベントも増えます。
ここで、一回のテストを20%速くするだけでは足りません。発火回数が二倍、三倍になれば、内部を高速化しても全体は詰まります。
先に問うべきなのは、テストコードの速度ではありませんでした。
この検査は、いま本当に走るべきか。
ここを設計しないままAIエージェントだけ増やしたため、GitHub Actionsが新しいボトルネックになりました。
9分31秒から2分09秒へ
Path-aware CIを入れたあと、docsだけを変更する実際のPull Requestでcanaryを行いました。
| 指標 | 従来のFull path | Docs-only | 差分 |
|---|---|---|---|
| 通常CIの完了時間 | 9分31秒 | 2分09秒 | 7分22秒短縮 |
| 削減率 | - | - | 77.4% |
| Postgres | 起動 | 起動なし | 省略 |
| Chromium | 導入 | 導入なし | 省略 |
| lint | 実行 | 省略 | 対象外 |
| typecheck | 実行 | 省略 | 対象外 |
| コード全テスト | 実行 | 省略 | 対象外 |
分類結果は次でした。
needs_code=false
needs_browser=false
needs_database=false
ただし、何も確認しなかったわけではありません。
公開情報や契約表現の整合、workflow safety、deploy policy、CI coverage、Agent運用ルール、静的なRLS coverageなど、Markdown変更でも壊れうる検査は残しました。
docs-onlyでも必要な検査は残し、その変更が影響しない実行基盤だけを起動しなかったということです。
最初にDraftのrunnerを止めた
作業中のDraft PRへ毎回full CIを投入しても、その結果は次のpushで古くなります。
従来はこうでした。
Draft PR
  ↓
push #1 → CI
  ↓
push #2 → CI
  ↓
push #3 → CI
  ↓
Ready → CI
変更後はこうです。
Draft PR
  ↓
push #1 → runnerなし
  ↓
push #2 → runnerなし
  ↓
push #3 → runnerなし
  ↓
Ready → CI
作業中の検査自体を捨てたわけではありません。ローカルや専用環境で変更範囲に応じた検査を行い、GitHub-hosted runnerはReady時の統合証拠へ寄せました。
「全部走らせる」を「変更を分類する」に変えた
CIの最初に、変更pathだけを見る軽量なclassify jobを置きました。
判定するのは三つです。
needs_code
needs_browser
needs_database
重要なのは、この判定をnpm ciより前に行うことです。
以前も後半のテストをskipする仕組みはありました。しかしskipを判断する頃にはrunnerが起動し、Postgresが立ち上がり、依存関係の導入まで終わっていました。
「走らせなかった」のに、費用と待ち時間の大半はもう使っていたわけです。
変更分類を入口へ移したことで、必要な実行基盤だけを起動できるようになりました。
分類器をPR側から実行しない
path-aware CIには重要な攻撃面があります。
PRが分類器自身を書き換えられると、自分を安全と判定して重い検査を消せます。
分類器はPR base SHA側の信頼済み版から実行し、PR head側の変更を判定ロジックへ持ち込みません。
CIや分類器そのものを変更するPull Requestは自己免除できないようfull pathへ倒します。
さらに、未知のpath、変更一覧取得失敗、分類不能、package.jsonやlockfile、Playwright設定なども安全側へ倒します。
SAFEと証明できる → skip可能
分からない        → run
高速化しても、安全側のデフォルトは反転させません。
exact-head検証をfull CIのコピーにしない
Pull Requestの現在HEADと検証対象SHAは一致している必要があります。
しかし同一性を確認するために、通常CIと同じfull suiteをもう一度走らせる必要はありません。
以前は同じHEADへ二つの重い検査が入っていました。
同じPR head
├─ 通常CI:lint / typecheck / 全テスト / Chromium
└─ exact-head CI:lint / typecheck / 全テスト / Chromium
役割を分けました。
Ready PR
├─ integration CI
└─ exact-head identity

Final Candidate
└─ exact-SHA full gate
同じ証拠を二重に作らない。必要な段階で、一度だけ強い検査を行う。この方が、どの結果を最終判断に使うのかも明確になります。
skipはPASSではない
この設計で、技術的な最適化と同じくらい重要だったのが証拠の意味です。
browser suiteをskipしたPRについて、browser: PASSとは記録しません。実行していないからです。
正しくはNOT_RUNです。なぜ省略できたのかを別の証拠として記録します。
同様に、Postgresを起動しなかったPRについて、DB検査が成功したとは言えません。
実行量の削減と、証拠の強度は別に管理する。
Final Candidateでは別のfull exact-SHA gateを持ち、必要な証拠を同じSHAへ揃えます。
検査を減らしたことで、欠陥が見えやすくなった
CIが多すぎると、失敗は情報としての意味を失い、騒音になります。
無関係なflaky testが落ちる。古いrunがキャンセルされる。同じSHAへ複数workflowが走る。どの赤が今回の変更に由来するのか、切り分ける仕事が増えます。
その結果、本当に見るべき欠陥より、CIをGREENに戻す作業へ時間を使います。
逆に、変更内容に近い検査を狭く確実に走らせると、失敗の意味が強くなります。
例えば、Next.jsのroute moduleへ余分なexportを置くと本番ビルドだけが落ちる問題がありました。毎Pull Requestで重い本番ビルドを追加する代わりに、同じ型の欠陥だけを数秒で検出する静的Gateを作りました。
重要なのは、検査時間の長さではありません。
過去に実際に起きた欠陥を、次に確実に止められるか。
ここを基準にすると、広く重い検査を毎回走らせるより、壊れ方に対応した小さなGateの方が強い場合があります。
起動しても状態を変えられないrunnerも止める
PR側のCIを軽くしても、周辺workflowが同じイベントへ反応すれば固定消費は残ります。
私たちのAgent Integration Controllerは、複数のAIエージェントが作ったPull Requestを評価し、統合可能なものをmainへ送るsingle-writerです。
以前はReady PRへpushした直後にもControllerが起動していました。しかしその時点ではCIが実行中なので、正常に動いてもmergeできません。
そこで通常の統合判断を、成功したCIの完了イベントへ寄せました。
Ready PR push
  ↓
CI
  ↓
CI success
  ↓
Controller 1回
Draft PRのCIがskipされたとき、CIがfailureやcancelledで終わったとき、Ready PRの新しいheadでまだCIが完了していないときはController runnerを起動しません。
Draft側で通常CIのrunnerを止めても、そのskip通知を受けて別のControllerが起動していたら固定消費は消えません。イベント連鎖全体を見る必要があります。
10分cronはrecovery fallbackへ落とした
Controllerにはイベント取りこぼしや一時障害から状態を再評価するscheduleもありました。
従来は10分ごとでした。
144回 / 日
4,320回 / 30日
scheduleはイベントを取りこぼしたときの回復経路に限定し、通常の統合はPRイベントとCI完了イベントで即時に起動します。
そこで1時間ごとへ落としました。
24回 / 日
720回 / 30日定期起動回数は83.3%削減です。
通常のPR統合待ち時間は増やさず、イベント駆動を通常経路として残し、cronは最大約1時間で再評価するrecovery fallbackへ役割を限定しました。
ここで得た原則は単純です。
このjobは必要か、だけでなく、いま起動してこのjobは状態を変えられるかを見る。
merge後のpost-merge checkにも同じ固定燃焼が残る
PR側を軽くしても、mainへmergeされるたびに別のpost-merge workflowが重い準備を無条件で始めれば、最適化は途中で終わります。
main postmerge checkも、変更分類を依存導入より前へ移しました。
docs-only / README-onlyでは、npm ci、事実整合チェック、lint / typecheck cacheのrestore、lint、typecheckを省略します。
一方、conflict marker検査は依存不要なので常時維持します。未知path、差分取得不能、分類不能はfail-closedでコード変更側へ倒します。
ここでも新しいdocs専用classifierを作らず、PR CIと同じ分類器を正本にしました。分類ロジックをworkflowごとに増やすと、片方だけ安全判定が緩むからです。
Draft → Ready → merge → Controller → post-mergeまで、ライフサイクル全体で「必要になる前に高価な準備を始めない」ようにする。
AIエージェント開発でActionsを削るときは、PR workflowだけでなく、merge後に連鎖するworkflowまで同じ発火予算で監査する必要があります。
2026年9月追記:AIエージェント組織では、CIは「検査」だけでなく「権限を持つ実行主体」になる
8月の改善では、不要なrunnerを起動しないことに集中しました。9月に運用を進めると、それだけでは不十分だと分かりました。
AIエージェントがworkflow自体を編集できる環境では、GitHub Actionsは単なるテスト実行環境ではありません。リポジトリへの書き込み、Pull Request操作、秘密情報、クラウドへのデプロイ権限まで持ち得る実行主体です。
そのため現在のNetsujoでは、Hosted CIをそのHEADを受け入れてよいかを判定する証拠面として扱い、探索用の計算資源には使いません。
作業中はDraftに置き、決定論的に落とせるものはローカルのexact-head gateで先に落とす。Readyは「このHEADをHosted CIで受入検証してほしい」という明示的な状態です。Ready後にcommit、rebase、mainの取り込みが必要になれば、変更HEADをpushする前にDraftへ戻し、古いPASSを新しいHEADへ流用しません。
この境界を置くと、GitHub Actionsの利用量を減らす話と、権限事故を防ぐ話が同じ設計へ収束します。
危険1:ReadyのままHEADを動かし、古いGREENを新しいコードの証拠にする
CI結果は検査したSHAに結びついています。Pull Request番号だけでは証拠対象を特定できません。
Readyになった後で新しいcommitを足したり、mainをmerge/rebaseしたりすれば、以前のGREENは別のコードに対する結果です。AIエージェントが「PRはGREENだった」とだけ記憶していると、ここを取り違えます。
現在の運用では、HEADが変わる変更は先にDraftへ戻します。変更後のexact HEADでローカルgateを通し、ReadyにしてHosted CIを取り直します。
古いPASSを再利用しないことは、CI回数を増やす話ではありません。検査対象を曖昧にしない話です。
危険2:pull_request_targetで未信頼のPRコードを実行する
GitHubの公式Security guidanceでは、pull_request_targetはbase repository側の権限やsecretへ到達できる強いイベントとして扱われています。
特に危険なのは、pull_request_targetで起動したworkflowが、forkや外部PRのHEADをcheckoutして実行する構成です。未信頼コードと、書き込み可能なtoken・secretが同じrunner上で出会います。
原則は分離します。
- 未信頼のPRコードを実行する検査は
pull_request側へ置く - secretやwrite権限が必要な処理は、未信頼コードを実行しない別workflowへ分ける
pull_request_targetが本当に必要な場合は、token権限・secret・checkout対象を最小化する
「CIが通るか」と「高い権限で何を実行してよいか」は別の判断です。
危険3:GITHUB_TOKENへ広いwrite権限を常時渡す
GitHubはGITHUB_TOKENについて、workflowまたはjob単位で必要最小限のpermissionsを明示することを推奨しています。
AIエージェントがworkflowを追加する組織では、権限を暗黙のdefaultへ任せない方が安全です。
permissions:
  contents: read

jobs:
  test:
    permissions:
      contents: read
PR作成、Issue更新、package publish、deployなどwriteが必要なjobだけ、その権限を局所的に追加します。
「このworkflowは何ができるか」を、YAMLを読めば分かる状態にします。
危険4:第三者Actionを可変tagだけで参照する
uses: vendor/action@v1のようなtagは人間には読みやすい一方、tag自体は不変ではありません。
GitHubのSecure use referenceは、第三者Actionを完全長のcommit SHAへpinすることを推奨しています。GitHubは、完全長SHAへのpinをActionを不変のreleaseとして使う方法として説明しています。
- uses: owner/action@<full-commit-sha>AIにworkflowを書かせる場合、「有名なActionだから」「v4だから」で通さず、どのコードを実行するのかを固定します。Dependabot等で更新PRを作り、差分をレビューしてSHAを進める方が、実行対象を追跡できます。
危険5:PRタイトルやbranch名をそのままshellへ埋め込む
GitHubのScript injectionsでは、issue/PRのtitle・body、head_ref、label、refなど、github contextの一部を未信頼入力として扱うよう説明されています。
次のように式を直接shell scriptへ展開すると、入力内容がコマンドとして解釈される余地を作ります。
# Avoid
run: echo "${{ github.event.pull_request.title }}"
値はまず環境変数やAction inputとして受け渡し、shell側ではデータとして引用して扱います。AIエージェントが「文字列を出すだけ」のつもりで生成した一行でも、workflowでは権限境界になります。
危険6:長期クラウド秘密鍵をrepository secretへ置き続ける
AWSやGoogle Cloudなどへdeployするための長期credentialをGitHub secretへ保存すると、そのsecretを読めるworkflowが増えるほど攻撃面も広がります。
GitHubはOpenID Connect(OIDC)を使い、長期credentialをGitHub secretとして保持せず、workflow実行時に短期tokenへ交換する構成を案内しています。
Production deployはさらにEnvironment protectionへ分けます。GitHub Environmentではprotection ruleが通るまでjobを開始せず、environment secretにもアクセスさせない構成を取れます。
permissions:
  contents: read
  id-token: write

jobs:
  deploy:
    environment: production
CI成功とProductionへの権限付与は、別イベント・別境界に分けます。
危険7:self-hosted runnerへ未信頼コードを載せる
self-hosted runnerは速く、キャッシュも効かせやすい一方、GitHub-hosted runnerと同じ使い捨て境界ではありません。
GitHubのSecurity guidanceは、特に公開repositoryのself-hosted runnerで未信頼PRを実行することへ強い注意を求めています。runnerに残るcredential、network到達性、他jobのartifactなど、ホストそのものが継続的な攻撃面になるからです。
AIエージェントの並列度を上げる目的だけでself-hostedへ寄せず、trusted workloadとuntrusted workloadを別の実行境界へ分ける必要があります。
GitHub Actionsの危険運用チェックリスト
| 危険な状態 | 安全側の設計 |
|---|---|
| Draftの途中commitごとにHosted CIを全実行 | Draftではローカルgate、ReadyでHosted acceptance |
| HEADが変わっても古いGREENを流用 | exact SHAを更新し、古い証拠を失効 |
pull_request_targetでPR HEADをcheckout・実行 | 未信頼コードとprivileged workflowを分離 |
GITHUB_TOKENが広いwrite権限 | workflow/job単位のleast privilege |
| 第三者Actionをtagだけで参照 | 完全長commit SHAへpin |
PR title/body/refを直接run:へ展開 | 未信頼入力としてenv/input経由で扱う |
| 長期cloud credentialを常設 | OIDCの短期token + Environment protection |
| 未信頼PRを永続self-hosted runnerで実行 | trust boundaryを分離し、必要なら隔離・ephemeral化 |
| Ready PRとmerge後mainで同じfull suiteを無条件に二重実行 | branch protectionと証拠の同一性を確認し、重複だけを除く |
| skipした検査をPASSと記録 | NOT_RUN + 省略理由を証拠化 |
最後の「post-mergeを減らす」は条件付きです。Ready PRで検査したexact HEADがbranch protectionを通ってそのままmainへ入ること、merge後だけに必要な検査が別に存在しないことを確認できる場合に限ります。
コスト削減の原則は、証拠がすでに存在する場所へ同じ証拠を取りに行かないことです。
品質は何分使ったかでは測れない
GitHub Actionsの利用時間が多いと、よく検査しているように見えます。
しかし品質を守るのはrunner minutesではありません。
見るべきなのは、どの欠陥を止める検査か、現在のSHAを検査しているか、必要な環境で実行したか、失敗が必ずGateへ届くか、そして省略した理由を説明できるかです。
この基準で見ると、重複実行を減らすことは品質低下ではありませんでした。
証拠の鮮度と意味を上げる改善でした。
減らしたのは重複と儀式だった
CIを減らすとき、一番危険なのは、速くしたいから検査を消すことです。それは手抜きになります。
必要なのは、各検査について次を説明できることです。
- どの欠陥を止めるのか
- どの変更で必要になるのか
- どの段階で証拠が必要か
- 省略したとき、別のGateで守られるか
- 判定に失敗した場合は安全側へ倒れるか
この説明ができないworkflowは、残っていても安心の儀式になりやすい。
私は以前、CIを多く走らせることを品質管理だと思っていました。
今は、品質管理とは、必要な欠陥を、必要な場所で、現在の変更に対して止めることだと考えています。
GitHub Actionsを減らしたら、検査が薄くなったのではありません。
何を確認しているのかが以前よりはっきりしました。
速いCIより、走らないCIを設計する
今回の改善では、テスト品質を維持したまま検査の発火条件を変えました。
- DraftではGitHub-hosted runnerを起動しない
- Readyで変更pathをnpm ciより前に分類する
- code、browser、databaseを別軸にする
- exact-headはidentity確認とfull validationを分離する
- 未知の変更とCI自己変更はfull pathへ倒す
- 分類失敗をrequired checkのFAILへ変える
- skipをPASSとして扱わない
- Final Candidateで必要なexact-SHA証拠を揃える
- 状態を変えられないタイミングではController runnerも起動しない
- cronを通常経路にせず、イベント駆動のrecovery fallbackへ限定する
- post-mergeも依存導入前に分類する
この結果、docs-onlyの実PRでは通常CIを9分31秒から2分09秒へ短縮できました。
これからのCIで最初に問うのは、「この検査は、いま本当に走るべきか」です。
必要な証拠は、必要な瞬間にだけ完全に揃える。
AIエージェントの速度をrunner待ちと請求額へ変えず、事業の速度へ変えるには、ここまでを設計対象にする必要があります。
FREE SLIDE DECK
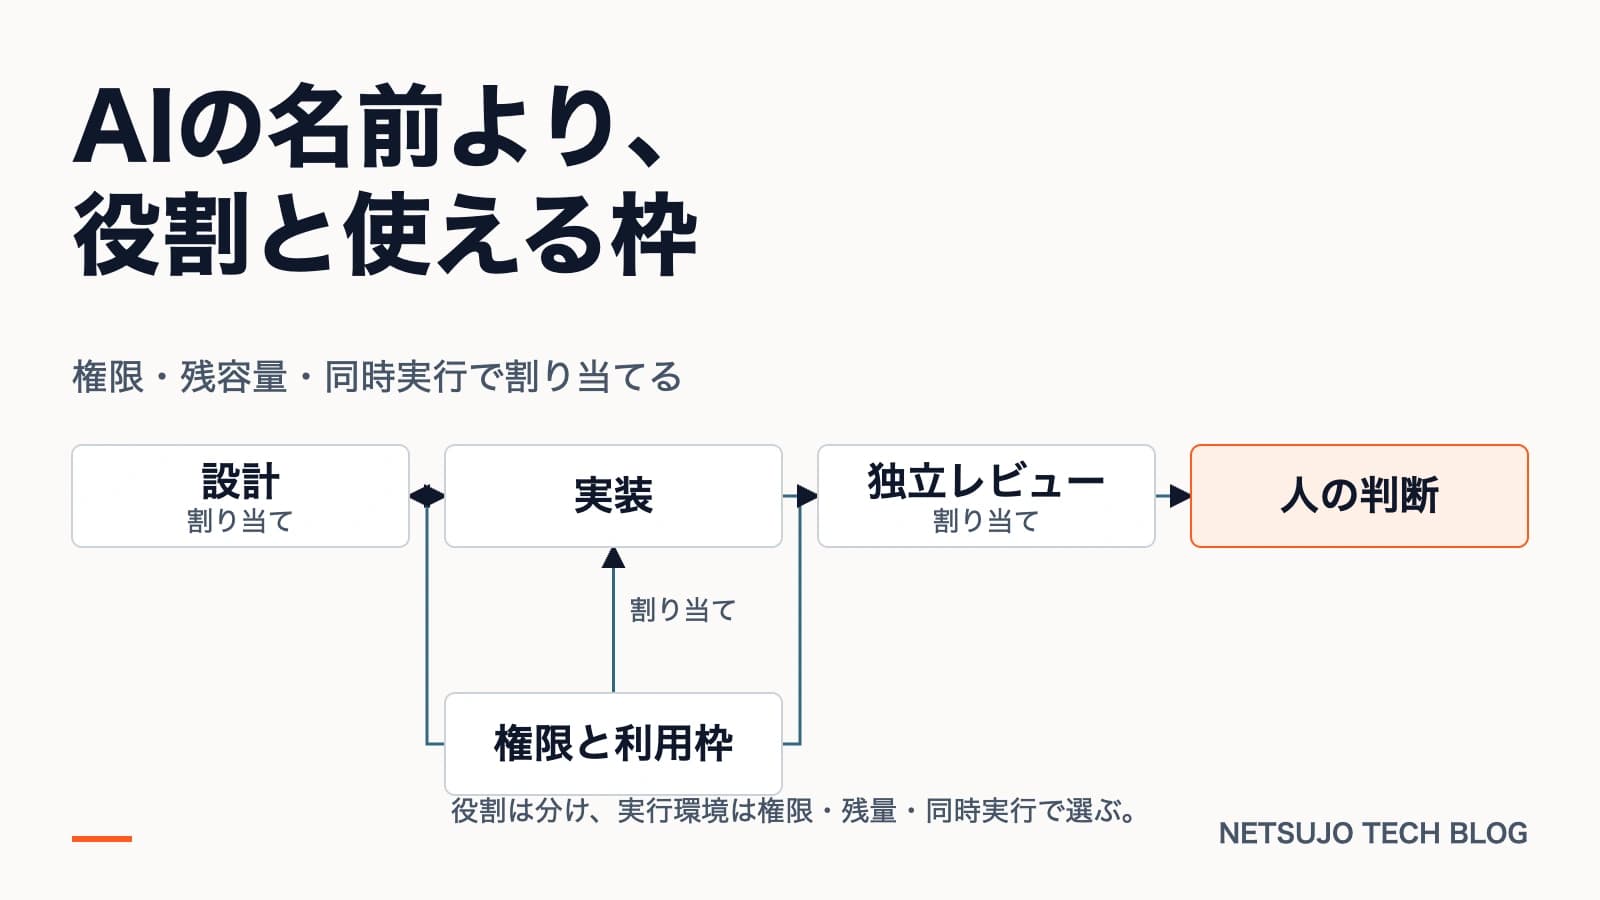
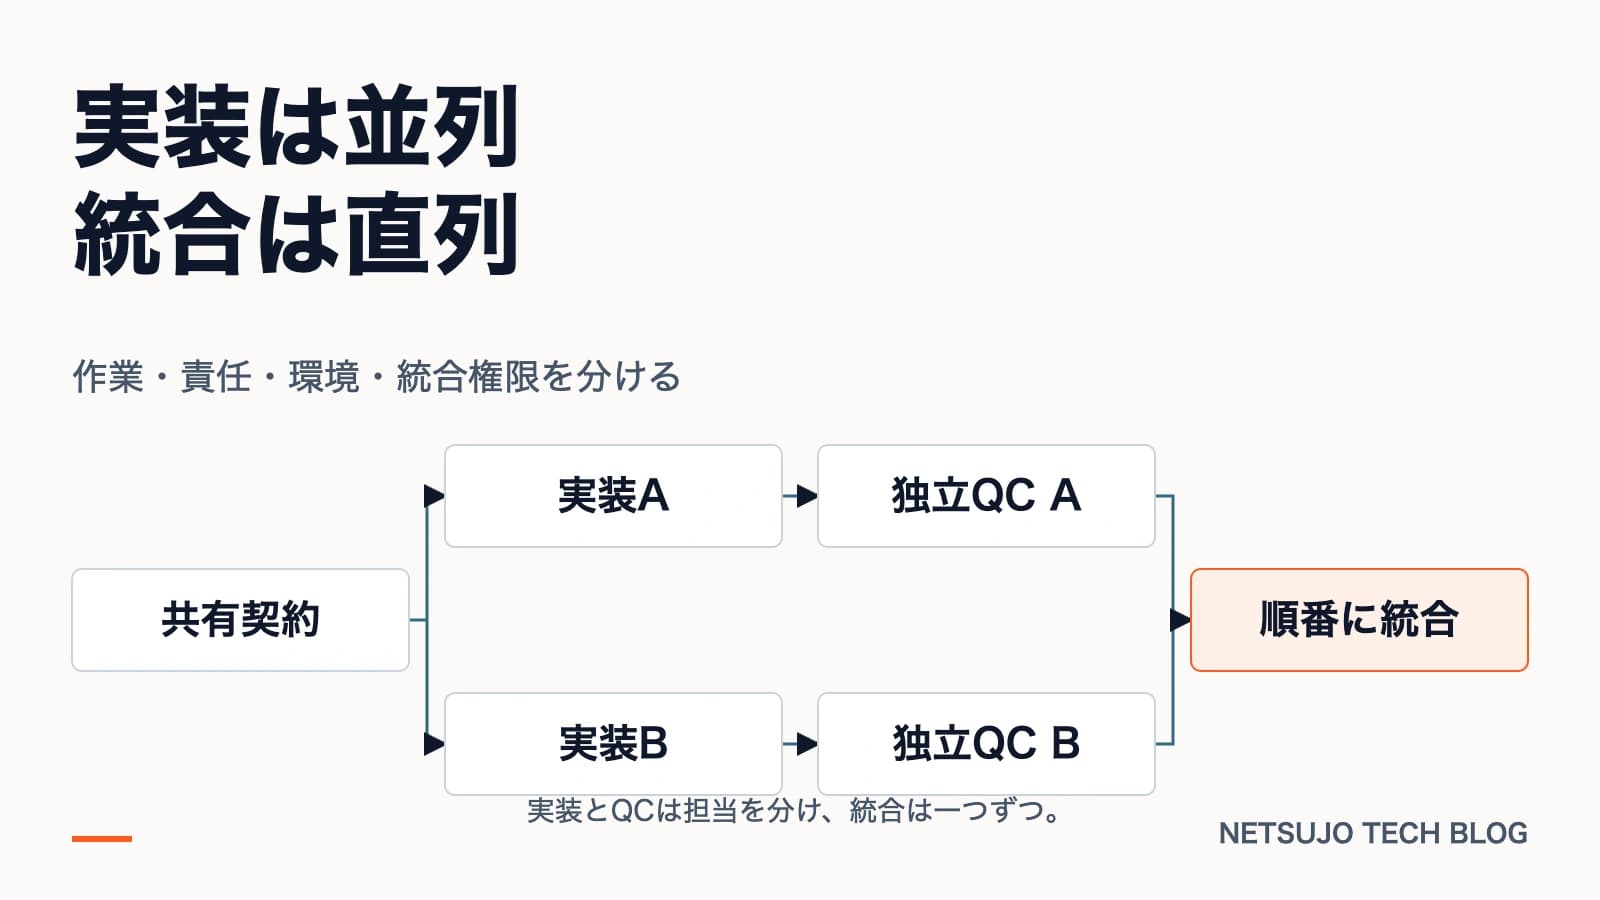
GitHub Actions 運用設計 — 20ページ
Draft / Ready、path-aware CI、exact-head、権限境界、OIDCまで、この記事の設計を実装例ベースで図解したPPTXです。会員登録なしでダウンロードできます。
PPTXをダウンロード(無料)
この記事の著者
飯田 友広
代表取締役
Netsujo株式会社 代表取締役。京都発のWeb3・AI実装スタートアップを2023年6月に創業。Webサイトを営業基盤として捉え、経営・営業・検索・生成AI・コンバージョン・計測を横断して課題と改善優先順位を整理する「Netsujo SIGNAL」を設計・運営。さらに、ChatGPT・Codex・Claude Codeを状態再構築、競合回避、独立QC、Exact-head検証、停止、復旧まで含む制御ループで運用する社内AI開発基盤「Netsujo Agent OS」を設計・実運転。Netsujoとして京都ビッグデータ活用プラットフォームに参画(小規模企業会員(ベンチャー))し、同プラットフォーム発のワーキンググループ「Chain Up KYOTO」にも参画(2026年3月10日〜)。IVS2026サイドイベント「なぜ京都でWeb3.0ビジネスなのか」はNetsujoとして京都府庁旧議場で主催・企画・登壇・運営(2026年7月2日/京都府 総合政策環境部 デジタル政策推進課は共催)。京都美術工芸大学・龍谷大学での講義に加え、京都高度技術研究所(ASTEM)、旅館業界、就労支援施設、Open Source Conference等で登壇実績。ITコミュニティ「みやこでIT」(connpassメンバー639名・イベント176件・2019年2月から運営)運営。NPO法人NEMTUS理事、BAR KRYPTO運営。Netsujoはソーシャル企業認証制度「S認証」の認証企業(2026年2月認証・2026年4月公表)。技術領域はWeb3/ブロックチェーン/DID/NFT/生成AI/コミュニティ運営。
プロフィールを見るこの記事が向いている方
Claude CodeやCodexなどのAIコーディングエージェントでPull Requestとpushの頻度が増えている開発責任者
GitHub Actionsの利用量を減らしたいが、required checkや品質ゲートを弱めたくないITエンジニア
複数AIエージェントの開発フローを、トークン・CI・Previewを含む実行予算として設計したい方
— 壁打ち相談
読者のよくある相談
記事を読んだ後に「自分の状況だとどう判断すべきか」を整理するための壁打ち相談を受け付けています。下記のような相談例が当てはまる方は、お気軽にご連絡ください。
Q. AIエージェントを増やしたら、GitHub Actionsの実行回数まで急増した
テスト時間だけでなく、Draft・Ready・Final Candidateごとのworkflow発火回数と重複を先に確認します。
Q. docs-only変更でもPostgresやbrowser testまで毎回走っている
変更pathを依存導入前に分類し、code・browser・databaseを別軸で起動します。
Q. CIを省略すると品質が落ちそうで怖い
SAFEと証明できる範囲だけ省略し、UNKNOWNとCI自己変更はfull pathへ倒します。skipはPASS証拠にしません。
上記いずれかが該当する場合、初回30分の壁打ち相談で論点整理に対応します。記事に書ききれない個別事情を踏まえた判断材料が必要な段階こそ、壁打ちが活きやすいフェーズです。
AI導入・PoC・業務実装のご相談
AIエージェントの速度を、運用コストへ変えない
AIエージェントの役割分担、Git運用、品質ゲート、CI、最終判断者までを一つの運用として設計します。構想段階からのご相談も可能です。