SEO・AIO
AI可視性の測り方
— 一回の点数ではなく、条件を固定した反復観測の分布として読む
AIへ一度質問し、自社が表示されたかどうかだけで「AI可視性」を評価する方法には限界があります。生成AIの回答は、同じ質問でも毎回同じになるとは限りません。質問の言い回しや言語、対象の地域、検索の有無、モデルの更新、参照時点によって、推薦される会社や引用URLが変わる可能性があります。そのため、AI可視性は一回の点数ではなく、条件を固定した反復観測の分布として読みます。
この記事は、AI可視性を数値で管理したいBtoB企業の担当者に向けて、何を可視性と呼ぶかの定義、観測条件の記録と条件の違う観測の分け方、質問の段階設計、反復回数の決め方、信頼区間の併記、総合スコアの限界までを順に整理します。ここで示すのは観測の作法であり、AI回答への掲載や引用を保証する方法ではありません。
この記事の要点
生成AIの回答は非決定的で、同じ質問でも実行ごとに出力が変わります。1回の観測は母集団から取り出した1サンプルにすぎず、単発の点数には再現性の裏づけがありません。
観測条件(質問文と質問セットの版・言語・国や地域・エンジン・モデル・検索の有無・実行日時・回数)を記録して固定し、複数回・複数条件で反復観測します。総合点に丸めず、言及率・引用選択率・引用吸収率など段階を分けた指標で観測します。
条件の違う観測は、同じ時系列に混ぜません。指定した地域と実際に確認できた地域は分けて記録し、確認できなければ不明のまま残します。未対応や実行失敗は言及0回として数えません。
観測率にはWilson信頼区間で幅を添え、条件ごとに層別します。施策の因果は簡単には言えないため、断定ではなく傾向として読む姿勢が現実的です。
— 01
AI回答は非決定的である
ChatGPT、Gemini、Google AI Overviewsなどの生成AIは、同じ質問を投げても、実行のたびに出力が変わることがあります。引用元の顔ぶれ、自社への言及の有無、表現の細部まで、毎回そろうとは限りません。これはサンプリングやモデル更新、Web検索の有無といった要因が絡むためで、バグではなく生成AIの仕様に近い挙動です。APIで温度やseedを固定すれば再現性を上げられる場合もありますが、通常の検索利用ではこの変動が前提になります。つまり1回の観測は、ばらつく母集団から取り出した1サンプルにすぎません。1サンプルから全体像を語るのは、統計的に無理があります。
— 02
一回の点数で判断できない理由
観測数が1のデータから「AI可視性◯点」と丸めると、その数字はたまたま引いた1回の結果に強く引きずられます。翌日に同じ質問を投げれば、言及されないことも、別の競合が前面に出ることもあります。単発の点数は精度が高そうに見えて、実際には再現性の裏づけがありません。数値の見栄えと信頼性は別物です。単発値を意思決定の根拠に据えると、存在しない変化を読み取ってしまう危険があります。AIに引用されない構造的な原因についてはAI検索で引用されない7つの原因も参考になります。
— 03
観測条件を固定して反復する
測り方の出発点は、条件を記録して固定することです。AI可視性は、特定の条件のもとで得られた観測結果です。比較する場合は、少なくとも次の項目をそろえて残します。この組み合わせが、その観測を識別する単位になります。
質問文と質問の目的:何を知りたい質問なのかを言語化して残す
質問セットの版:質問を追加・変更したら版を改め、どの版の結果かを残す
指名/非指名:会社名を含む質問か、カテゴリで探す質問か
言語(ロケール):ja-JP、en-US、en-GBのように地域の表記まで残す。同じ英語でも別の条件として扱う
対象の国・地域:指定した地域と、実際に確認できた地域を別々に記録する
対象業種:候補集合が変わるため必ず分けて記録する
使用したAIサービス:どのサービス・どの経路で観測したか
モデルまたはモード:同じサービスでも出力が変わるため区別する
検索機能の有無:Web検索を使ったかどうかで引用元が変わる
実行日時と実行回数:いつ・何回観測したかを分母として残す
根拠URL:回答が参照した公開URLを、観測時点の証拠として結果と一緒に残す
たとえば、「京都でAI開発を相談できる会社」と「製造業のRAG導入を相談できる会社」では、候補集合が異なります。質問を一括して平均すると、どの市場で見つかっているかが分からなくなります。条件を変えながら繰り返し観測すると、1点の数値ではなく「どのくらいの観測率で、どんなばらつきで登場するか」が見えてきます。引用元URLの記録方法や、Search Consoleと外部AIの引用観測を分けて追跡する実務はGoogle AI機能の計測方法で扱っています。
指定した条件と、確認できた条件を分ける
言語や地域の指定は、観測への入力です。AIサービスがその地域の検索結果や情報源を実際に使ったかどうかは、別に確かめる必要があります。回答や引用元から確認できなければ「不明」と記録し、指定した地域で観測できたとは書きません。指定した値を、確認できた値の欄へ流用しないことが前提です。
市場の条件が違う観測を、同じ系列に混ぜない
言語、国や地域、AIサービス、モデル、検索モード、質問セットの版のどれかが違う観測は、別の系列として扱います。たとえばen-US(米国)とen-GB(英国)は同じ英語ですが、候補になる企業や参照される情報源が同じになるとは限らず、どこまで違うかは観測するまで分かりません。二つを平均して一本の推移にすると、数値の変化が施策によるものか、条件の違いによるものかを区別できなくなります。日本語・日本市場での観測結果を、海外市場でも同じ傾向になる根拠として読み替えることも避けます。
ここでいう地域は、指定した地域と、AIサービス側で確認できた地域という別々の項目です。同じ系列かどうかを判断するときは、両方を照合します。確認できた地域が分かっている場合、指定した地域が同じでも、確認できた地域が違う観測は同じ系列として比べません。確認できた地域が不明な場合は「不明」を一つの状態として扱い、ほかの条件がすべて同じで、確認できた地域も不明な観測とだけ比べます。確認できた地域がそろった系列へ、不明な観測を黙って混ぜることはしません。これは比較の単位を分けるための扱いです。確認できた地域が不明でも、結果を判定できた観測を無効にする理由にはならず、分母の扱いは次に述べるとおりです。
実行できなかった観測も同じ考え方で扱います。言語と地域の組み合わせに対応していない、AIサービス側が地域の指定を受け付けない、実行が失敗した。こうした観測を「言及0回」として集計すると、見つからなかった結果と測れなかった結果が混ざります。対象の市場に対応していない観測、地域の指定を受け付けられなかった観測、実行に失敗した観測、回答の結果そのものを判定できない観測は、言及0回として数えず、観測率の分母にも入れず、状態ごとの件数として残します。一方、AIサービスが実際に使った地域を確認できず「不明」のままでも、指定・記録した条件のもとで回答の結果を判定できる観測は有効な観測です。確認できた地域の欄は「不明」のまま残し、分母には含めます。対応していない言語を、別の言語へ黙って置き換えて観測しないことも、観測ルールの前提とします。
— 04
質問を段階別に設計する
観測する質問は、顧客の検討段階に沿って分けます。段階ごとに、必要なページと回答内容が変わるためです。
| 検討段階 | 質問の例 |
|---|---|
| 課題認識 | 問い合わせが増えない原因は何か/社内文書を生成AIで検索する方法は何か |
| 解決方法 | RAGとAIエージェントの違いは何か/BtoBサイトを改善する進め方は何か |
| 比較 | 京都でAIエージェントを開発できる会社/Web3のPoCを構想から実装まで支援できる会社 |
| 発注 | AIエージェントPoCの費用/SEO分析からコード実装まで依頼できる会社 |
課題認識の段階で見つかっていないのか、比較の段階で候補から外れているのかで、直す場所が変わります。段階を混ぜて一つの数値にすると、この違いが消えます。
— 05
何を可視性と呼ぶかを決める
AI可視性という言葉には、複数の状態が含まれます。混ぜて一つの点数にすると、改善箇所を判断できません。
言及:回答本文に会社名やサービス名が出ること
推薦:候補として選ばれ、利用者の条件に合う理由が説明されること
引用:情報源として自社URLが表示されること
内容反映:自社ページに書かれた特徴、料金、実績などが回答へ使われること
正確性:会社名、サービス、料金、対象顧客などが正しく説明されること
行動:回答を見た利用者がサイトへ移動し、問い合わせること
この状態を観測できる形に置き換えたものが、次の指標です。Netsujo SIGNALでは、反復観測の集計を行う分析側で、この6指標を観測単位として扱っています。スキャン単体で機械判定しているのは、このうち言及と公式サイト引用にあたる部分です。
言及率(mention rate):AI回答に自社やブランドが登場した観測率
引用選択率(citation selection rate):引用元として選ばれた観測率
引用吸収率(citation absorption rate):引用が実際に回答本文の内容へ反映された観測率
裏付け主張率(supported claim rate):検証可能で裏づけのある主張の観測率
回答エンティティ一貫性(answer entity consistency):回答内での自社情報の一貫性
競合の同時出現(competitor inclusion):競合が同時に言及される度合い
なお、引用選択率・引用吸収率(citation selection rate / citation absorption rate)は、検索エンジンやAIベンダーが定義した公式・業界標準の指標ではありません。診断のために本稿で区分する操作的な指標です。定義や測り方は運用者ごとに差があり得る前提で扱ってください。
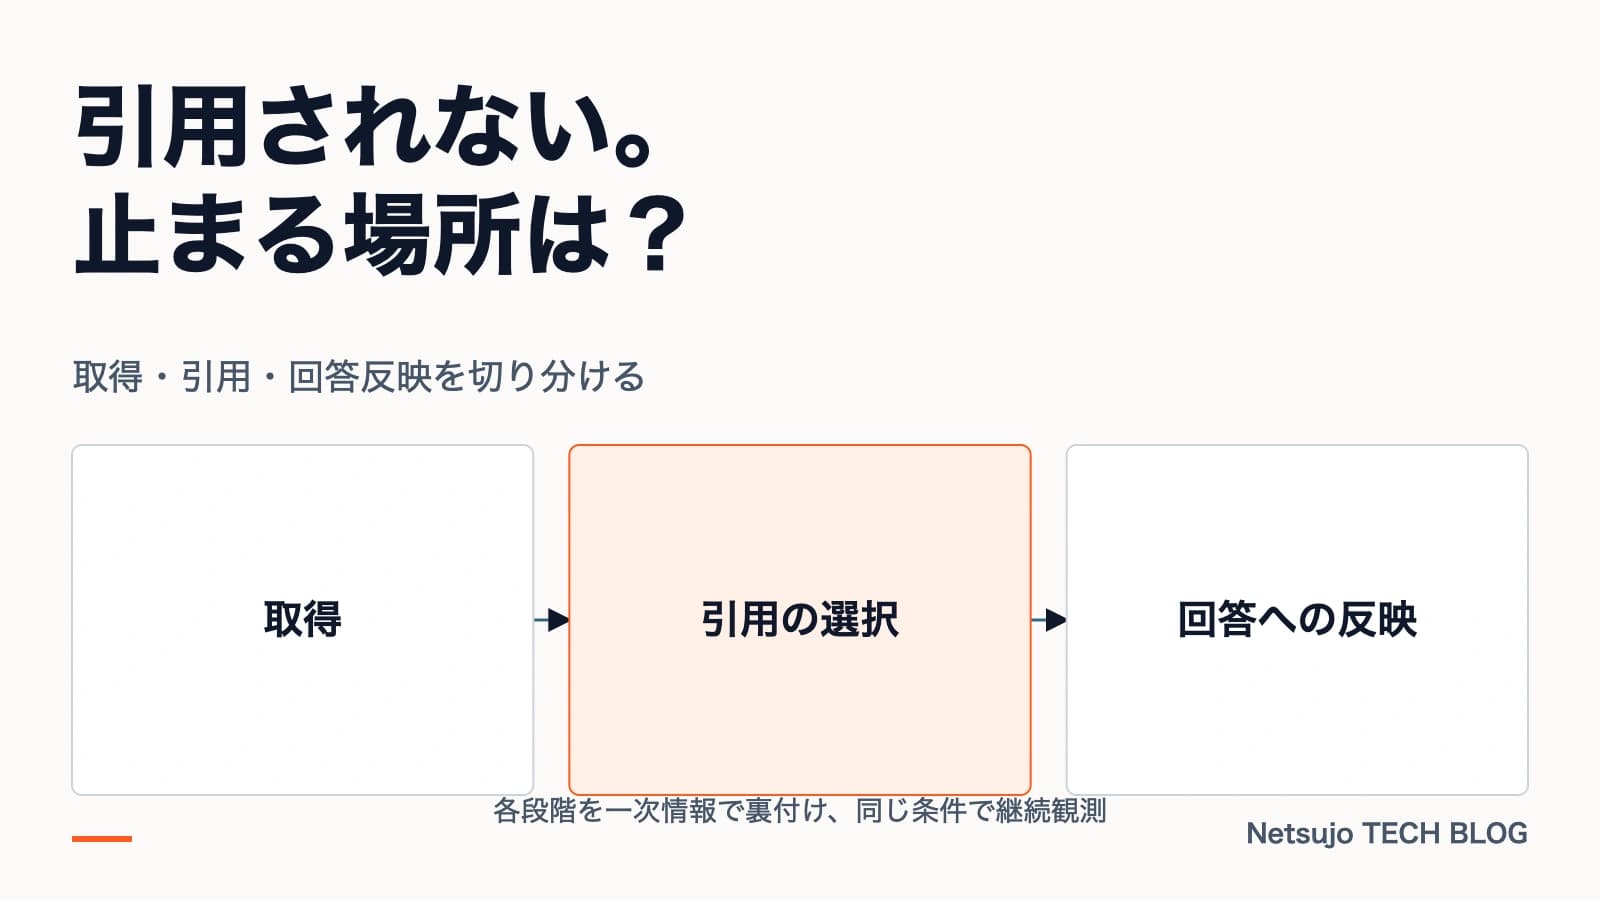
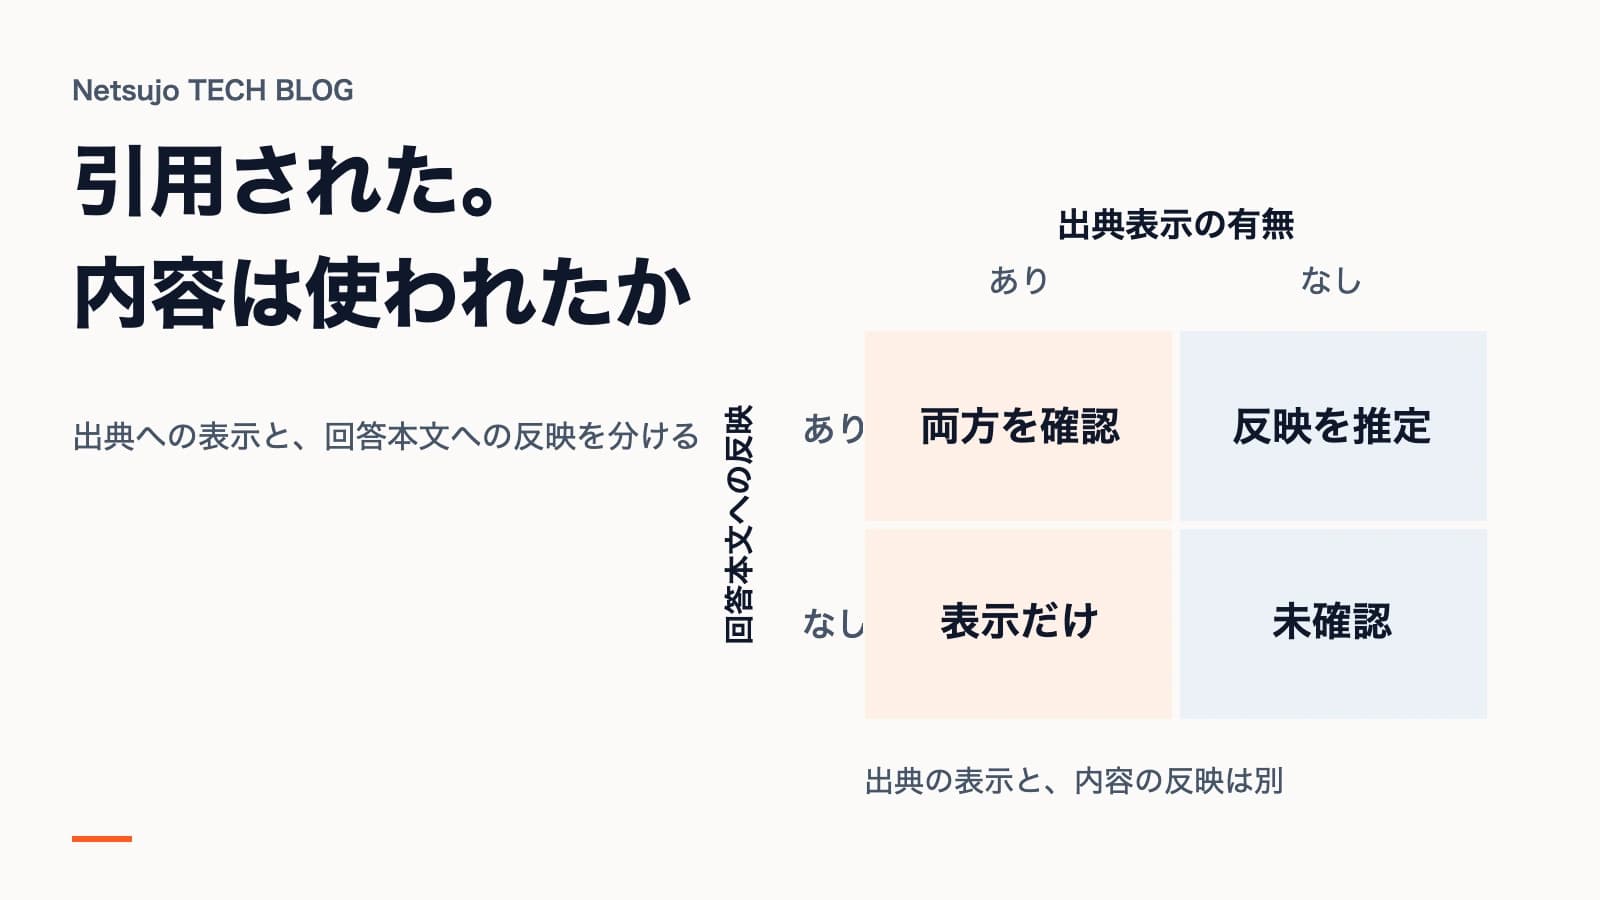
引用元に選ばれることと、その内容が回答本文へ反映されることは別の現象です。この違いは引用と回答反映の違いで詳しく整理しています。段階を分けることで、どの層でつまずいているかが切り分けられます。
— 06
反復回数を決める
一つの質問を一回だけ実行しても、出現の傾向は分かりません。たとえば、同じ条件で20回観測し、6回言及された場合、観測率は30%です。ただし、30%が本来の水準だと断定できるわけではありません。標本数が少ないほど不確実性は大きくなります。
一律の正解はないため、当社の実務では次のいずれかを基準に回数を決めています。普遍的な基準ではなく、運用上の目安です。
予算上の上限:1回の観測にかかる費用から、月あたりの実行回数を先に決める
検出したい差の大きさ:前月との差をどこまで見分けたいかから逆算する
信頼区間の幅:区間が判断可能な幅になるまで試行を積む
質問の重要度:重要な比較質問は反復数を増やし、探索的な質問は少ない回数から始める
— 07
観測率には信頼区間を添える
観測率だけを表示すると、30%と32%の差が意味のある変化に見えます。実際には、標本数が少なければ誤差の範囲かもしれません。反復観測で得た観測率は有限の試行から推定した値なので、二項比率の信頼区間を使って、推定に伴う不確実性の目安を参考区間として併記します。SIGNALでは、反復観測を集計する分析側でWilson信頼区間(既定は95%水準)を使っています。少数の試行でも、正規近似のように区間が0〜1の外へはみ出したり過度に狭くなったりしないためです。
信頼区間は「真の値がこの幅に入る確率」を表すものではありません。同じ手順を繰り返したときに、区間が真の値を含む頻度の目安です。独立に近い反復観測であることが前提になります。
経営向けの表示では、次のような形が扱いやすくなります。
- 言及:6/20回
- 観測率:30%
- 推定範囲:参考値として併記
- 前月:5/20回
- 判断:明確な改善とは言えない
精密な数字に見せるより、判断可能な情報を出すことが目的です。区間が広ければ、まだ試行を積む段階だと読めます。なお、Wilson信頼区間は同一条件内の二項比率の目安です。エンジン・モデル・実行日・言語・地域といった条件を混ぜて1本の区間に丸めると解釈が崩れるため、条件ごとに層別して見ることが前提になります。
— 08
総合スコアを使う場合の制約
複数の指標を一つにまとめて表示する場合は、次の項目を同時に公開します。公開しないまま点数だけを出すと、受け取る側が意味を検算できません。
構成指標と重み
対象質問と対象エンジン
対象の言語と国・地域
実行回数
欠測の扱い
更新日
スコアが表さない範囲
総合スコアは、月次の変化を一覧する補助には使えます。しかし、改善施策の選定には段階別指標を使います。たとえば、引用率が高くても、料金情報が誤っていれば正確性の改善が必要です。引用率が高くても問い合わせが発生しなければ、CTAやサービス説明を見直す必要があります。
— 09
施策の成果と断定しない
記事を公開した翌月に言及率が上がっても、その記事が原因とは限りません。次のような要因が同時に影響するためです。
モデルの更新
検索インデックスの変化
競合の公開情報
SNSやイベント
質問文の差
季節性
サービスのニュース
施策の評価では、公開前後の期間を固定し、変更したページ、質問群、他の活動を記録します。可能であれば、変更していない質問群も比較対象にします。生成AI検索への向き合い方は生成AI検索もSEOやGEOでも扱っています。因果ではなく傾向として読む姿勢が現実的です。
— 10
実務で使う最小レポート
AI可視性の月次レポートは、次の項目で足ります。
対象期間
質問群と目的
エンジン・言語・地域と回数
未対応・地域指定の拒否・実行失敗・結果判定不能の件数(観測率の分母に含めない)
確認できた地域が「不明」の観測の件数(結果を判定できていれば分母に含める)
言及率・引用率・正確率
誤回答の内容
前月との差
信頼区間または不確実性
公開した変更
次に直すページ
判断を保留する項目
二つの「不明」は分けて数えます。確認できた地域が不明な観測は、回答の結果を判定できていれば観測率の分母に入ります。回答の結果を判定できない観測は分母から外し、件数だけを残します。一つの「不明」にまとめると、どの観測を分母に入れ、どれを外したのかを後から確かめられなくなります。
「点数が上がった」という報告より、「どの質問で、どの段階が変わり、次に何を直すか」が分かる方が実装につながります。
— 11
Netsujo SIGNALの考え方
Netsujo SIGNALでは、AI可視性を一回の判定で断定しません。質問を顧客の検討段階に分け、複数回観測し、言及・引用・正確性を分けて確認します。個別サイトを対象としたスキャンの実行条件は、次のとおり方法論ページで公開しています。
| 項目 | 個別スキャンの実行条件 |
|---|---|
| 質問数 | 入力情報に応じて、指名・サービス・課題・最新の最大4系統を対象ごとに生成 |
| 反復数 | 各質問を既定2回実行し、観測率として集計 |
| エンジン | OpenAI Web Search。Perplexity Sonarは実装済みだが現時点では未有効 |
| 計算式 | 100点満点。AI存在率25点+情報正確性30点+公式サイト引用率20点+AI回答内シェア15点+情報鮮度10点 |
| 判定 | 言及と公式サイト引用は機械判定。正確性と鮮度は自動仮判定のうえ人間が確認して確定または棄却 |
信頼区間の併記は、反復観測を継続して集計する分析側の処理です。スキャン単体が提示するのは観測率とスコアの参考値までで、区間そのものは表示していません。管理対象の観測では、エンジン・モデル・検索の有無・質問条件として記録する地域・実行日時を個別のレポートへ記載します。
管理対象のAI回答可能性観測では、言語と国・地域の組み合わせを市場条件として扱い、対応していない組み合わせは推測で補わず止める仕組みを2026年9月30日時点で運用環境へ反映しています。ただし、この市場契約は管理対象の観測サブシステムの境界で、公開無料診断が海外市場に対応したことを意味しません。無料診断は日本語の質問・日本語UIを使います。保存・表示されるロケールや地域情報だけでは、AIサービス側で確認された観測市場を証明できません。日本以外の市場での観測結果、市場差の知見、海外向けの利用実績は、まだ公開していません。
質問セット・判定基準・実行回数・エンジンを変更した場合はバージョンを更新し、履歴を残します。詳しい条件はSIGNAL Labの方法論に掲載しています。
無料診断で表示する数値は、観測条件を限定した参考値です。市場全体での絶対的な水準を表すものではなく、順位やAI掲載を保証するものでもありません。診断で分かることと分からないことはAIO診断で分かること・限界で整理しています。重要なのはスコアの高さではなく、止まっている段階を特定し、実装可能な改善へ変換することです。実践の記録は実践ログにまとめています。
— FAQ
よくあるご質問
なぜ1回の観測ではAI可視性を測れないのですか。
生成AIの回答は非決定的で、同じ質問でも実行ごとに引用元や言及の有無が変わります。1回の観測は母集団から取り出した1サンプルにすぎず、標本数が不足しているため、単発値では再現性を保証できません。
何回くらい観測すればよいですか。
一律の正解はありません。目安は、観測率の信頼区間が判断に足るまで狭まるかどうかです。試行が少ないうちは区間が広く、断定を避けるべき段階だと判断できます。予算の上限、前月との差をどこまで検出したいか、質問の重要度によっても回数は変わります。provider・model・日・表現などの条件も変えながら積み重ねます。
総合スコア1本で管理してはいけませんか。
総合スコアに丸めると、言及率・引用選択率・引用吸収率などのどの層で起きた変化なのかが見えなくなります。月次の変化を一覧する補助には使えますが、改善施策の選定には段階を分けた指標を使います。総合スコアを示す場合は、構成指標と重み、対象質問、対象エンジン、対象の言語と国・地域、実行回数、欠測の扱い、更新日、スコアが表さない範囲を併せて公開します。
AI可視性スコアが上がれば施策の成果と言えますか。
言い切れません。モデルの更新、検索インデックスの変化、競合の公開情報、質問文の差、季節性など、自社の施策以外の要因が同時に動きます。公開前後の期間を固定し、変更したページと質問群を記録したうえで、変更していない質問群とも比べる形にすると、読み違いを減らせます。
SIGNALを使えばAIに必ず引用されますか。
いいえ。SIGNALは反復観測・段階別指標・信頼区間で可視性の分布を把握するための測定ツールであり、順位やAI掲載を保証するものではありません。無料診断は無料で、その先の有料メニューの最新の料金は料金ページに掲載しています。
この記事の著者
飯田 友広
代表取締役
Netsujo株式会社 代表取締役。京都発のWeb3・AI実装スタートアップを2023年6月に創業。Webサイトを営業基盤として捉え、経営・営業・検索・生成AI・コンバージョン・計測を横断して課題と改善優先順位を整理する「Netsujo SIGNAL」を設計・運営。さらに、ChatGPT・Codex・Claude Codeを状態再構築、競合回避、独立QC、Exact-head検証、停止、復旧まで含む制御ループで運用する社内AI開発基盤「Netsujo Agent OS」を設計・実運転。Netsujoとして京都ビッグデータ活用プラットフォームに参画(小規模企業会員(ベンチャー))し、同プラットフォーム発のワーキンググループ「Chain Up KYOTO」にも参画(2026年3月10日〜)。IVS2026サイドイベント「なぜ京都でWeb3.0ビジネスなのか」はNetsujoとして京都府庁旧議場で主催・企画・登壇・運営(2026年7月2日/京都府 総合政策環境部 デジタル政策推進課は共催)。京都美術工芸大学・龍谷大学での講義に加え、京都高度技術研究所(ASTEM)、旅館業界、就労支援施設、Open Source Conference等で登壇実績。ITコミュニティ「みやこでIT」(connpassメンバー639名・イベント176件・2019年2月から運営)運営。NPO法人NEMTUS理事、BAR KRYPTO運営。Netsujoはソーシャル企業認証制度「S認証」の認証企業(2026年2月認証・2026年4月公表)。技術領域はWeb3/ブロックチェーン/DID/NFT/生成AI/コミュニティ運営。
プロフィールを見るこの記事が向いている方
AI可視性を数値で管理したいが、一回の点数の扱い方に迷っているBtoB企業の担当者
生成AI検索での見え方を、誠実な統計の作法で測りたい方
総合点ではなく段階別の指標で、どこでつまずいているかを切り分けたい方
— 壁打ち相談
読者のよくある相談
記事を読んだ後に「自分の状況だとどう判断すべきか」を整理するための壁打ち相談を受け付けています。下記のような相談例が当てはまる方は、お気軽にご連絡ください。
Q. AI可視性は何回くらい観測すればよいですか?
観測率の信頼区間が判断に足るまで狭まるか、という観点で観測設計を一緒に組み立てます。
Q. 総合スコアと段階別指標のどちらで管理すべきですか?
課題の切り分けには段階別が有効です。目的に合わせて指標設計を壁打ちします。
Q. 観測した数値の変化を施策の成果と見てよいですか?
交絡や非決定性を踏まえ、断定ではなく傾向として読む前提を一緒に確認します。
上記いずれかが該当する場合、初回30分の壁打ち相談で論点整理に対応します。記事に書ききれない個別事情を踏まえた判断材料が必要な段階こそ、壁打ちが活きやすいフェーズです。
関連するサービス
Web営業基盤|Netsujo SIGNAL
まず無料で、AI可視性の現状を確認する
無料診断でAI検索での見え方と最初の修正指示を確認し、その先の反復観測と段階別指標で優先すべき改善を特定します。順位やAI掲載を保証するものではありません。