
AI開発・事業判断
AIでコードが速く書けても、仕事が完了しない――「検証済み成果」までのコストを測る
生成AIでコードが速く書けても完了件数が伸びないことがある理由を、レビュー工程・完了1件の総費用・検証済み成果から調べます。
著者:飯田 友広
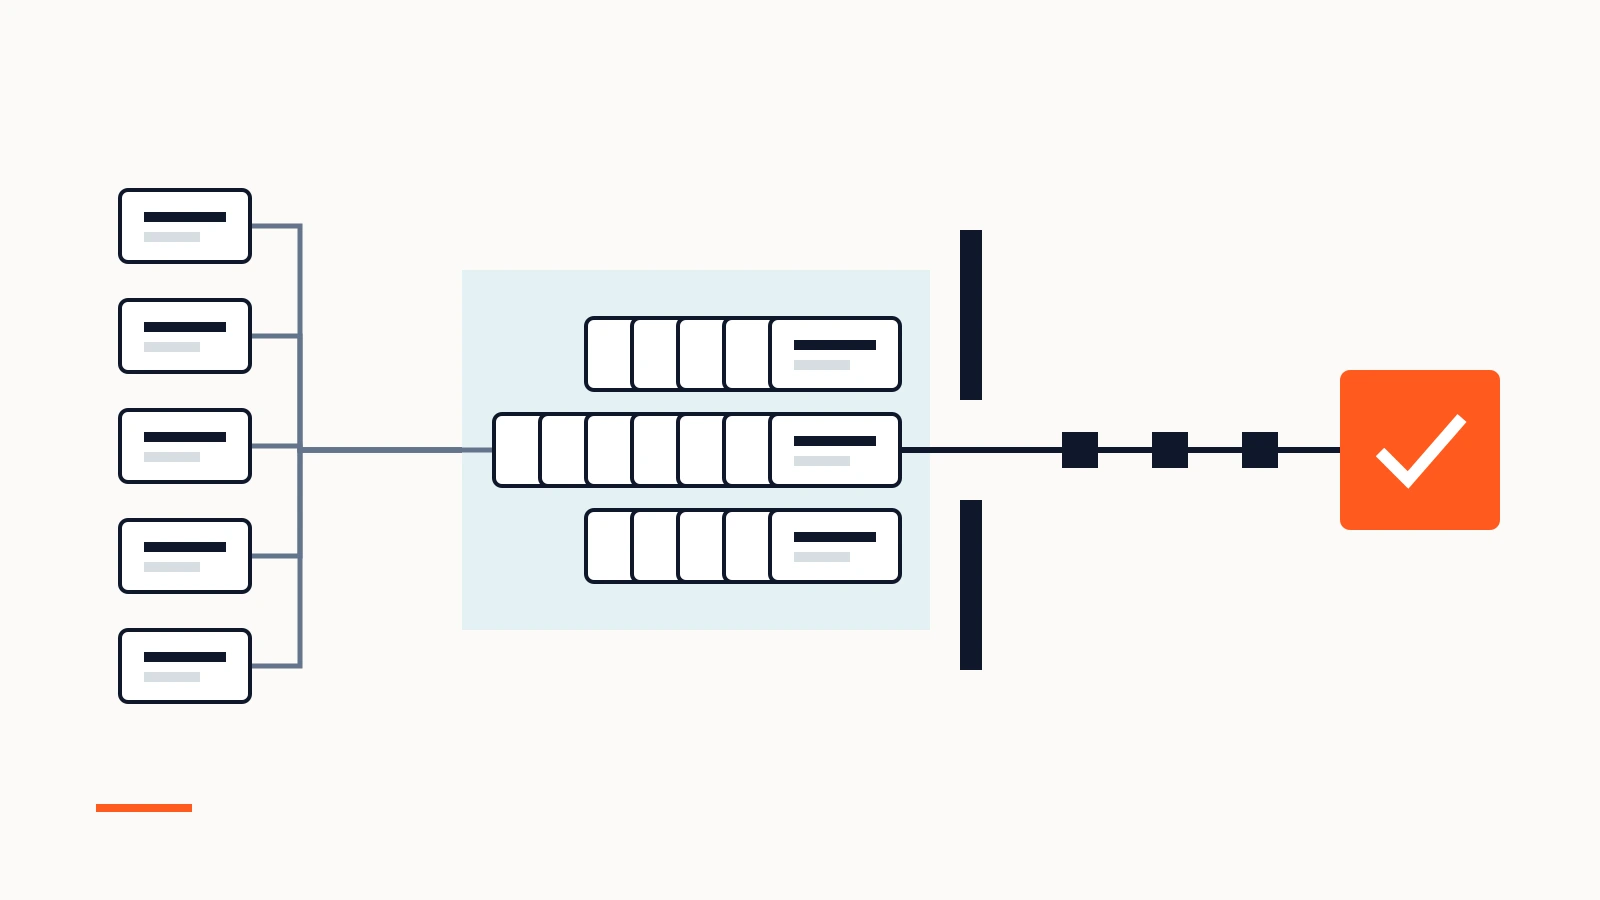
AIエージェントに実装を任せると、コードの作成速度は上がることがあります。開発責任者が求める成果は、変更が品質・権限・本番環境の確認を通り、利用者の課題を解決した状態です。
この区間が長いと、AIを増やすほどレビュー待ち、再指示、確認依頼が積み上がります。投資判断に必要なのは「AIで何時間書く時間を節約したか」から一段進んだ、受け入れられた成果1件あたりの総費用という視点です。
例えば「問い合わせボタンを直す」が、確認待ちで一日仕事になることもある
小さな修正を考えます。BtoB企業のWebサイトで「お問い合わせ」ボタンがスマートフォンから押しにくいため、表示とリンク先を直す仕事です。AIに修正を依頼すると、変更自体は数分で提示されるかもしれません。
顧客が買っている成果は、スマートフォンでボタンを操作でき、目的のフォームへ到達し、既存の導線にも支障がない状態です。次の表は、実案件の実測ではない説明用の仮想シナリオです。
| 報告された状態 | その時点で成立していること | 顧客に残る不確実性 |
|---|---|---|
| 「修正しました」 | ファイルに差分が存在する | 対象ページに反映されるか |
| 「テストが通りました」 | 指定テストが特定の版で成功した | スマートフォンで押せるか |
| 「マージしました」 | 統合先のコードが更新された | 公開環境へ配備されたか |
| 「デプロイ成功です」 | 配備基盤が変更を受理した | 顧客が開くURLに届いたか |
| 「公開画面で押せました」 | 検証者の画面では操作できた | 実際の利用者・端末条件でも目的を果たせるか |
一つひとつの報告が証明する範囲を区別し、次の状態は別途確認します。各工程の責任者も異なります。開発者はコードを見て、品質担当者はテストを見て、運用担当者は配備記録を見て、顧客は実際の画面を見ます。
ここで人間が毎回「それは本番?」「最新の変更?」「使えることまで確かめた?」と聞き直しているなら、作業をつなぐための情報がシステムに残っていない可能性があります。報告の上手さを改善するより先に、誰がどの工程を受け入れたかを追えるようにする方が改善点を特定できます。
特に混同しやすいのは作業時間と待ち時間です。AIが作業した時間が短くても、レビュー担当者の確認を翌日まで待つことがあります。APIの実行費用には待ち時間が現れませんが、問い合わせ導線の改善が顧客へ届く日付には影響します。費用と納期を分けて計測する理由はここにあります。
公開調査に見る、後工程への負担
Black Duckの委託によりUserEvidenceが2026年3月に実施した、ソフトウェアエンジニア・DevOps担当者831人への調査(ベンダー委託調査)では、AI生成コードの開発上のボトルネックとして、手動レビュー52%、セキュリティテスト51%、コードの手戻り48%が挙がりました。この数値は調査回答者が挙げたボトルネックの割合であり、世界全体への一般化には調査設計上の限界があります。
Stack Overflow Developer Survey 2026では、AIの出力について「容易に検証できるとき信頼する」を選んだ人が48.0%(6,872人/この設問の回答者14,304人)。重要な仕事上の判断を含めて信頼する回答は6.6%(949人)でした。AIの導入が広がっても、最終確認の需要がなくなると考える根拠にはなりません。
LangChainの2026年調査でも、1,300人以上の回答者のうち32%がエージェントの本番導入における障害として品質を挙げています。一方で可観測性の導入が進んでいるという報告もあります。操作のログが取れていても、顧客が期待した結果を受け入れたかの検証設計は別途必要です。
これらは母集団も設問も異なる調査です。数字の大小を直接比較せず、「生成後のレビュー・検証・運用」が共通の経営課題になっていると読み取るのが妥当です。
実例:公開OSSのPASSは、工程全体の完了を示さない
Netsujoの公開OSS Agent Role Contracts には、役割と作業範囲の宣言を点検するスターターデモがあります。実装役の宣言が許す範囲へタスクを置くとPASS。タスクを宣言外のパスへ変えると TASK_WRITE_SCOPE_OUTSIDE_AUTHORITY でFAIL。タスクを戻すと再びPASSとなる、という期待結果をソース上で確認できます。
この検査が答えるのは、渡された宣言に矛盾があるかという一つの問いです。実際にファイルを変更したか、別のレビュアーがソースを検査したか、本番の画面が正しいかまでは示しません。デモの出力にも実行は許可されていないと明記されています。
ここから得られる経営上の教訓は、検証の各工程で「何を確認したか」を明示することです。一つの正しいPASSを工程全体の完了と取り違えると、残りの費用と日数が見えなくなります。
「完了」を、成果物に合わせて七つの工程へ分ける
Webサービスの変更なら、次の区分が考えられます。
| 工程 | 必要な証拠の例 | それだけで分からないこと |
|---|---|---|
| 1. 実装 | 変更ファイルとコミット | 要件を満たすか |
| 2. 局所検証 | 単体テスト・型検査 | 他機能への影響 |
| 3. 独立した品質確認 | 正確なHEADに対するレビュー結果 | 本番で動くか |
| 4. 統合 | マージ先とコミットID | デプロイされたか |
| 5. 配備 | 配備先とデプロイID | 公開ドメインで見えるか |
| 6. 本番読戻し | 公開URL・画面・操作結果 | 顧客の目的を果たしたか |
| 7. 利用受入 | 合意した利用シナリオの結果 | 継続的な事業成果 |
すべてのタスクに七工程を強制する意味はありません。技術検証の仕事なら「テストを再現できる」ことがDONEかもしれません。顧客向けの機能改善なら、実利用までがDONEになります。作業開始時に到達点を固定し、未完了の工程を隠さないことが重要です。
また、レビュー結果はバージョンに結び付けます。同じPRでもHEADが変われば検証対象が変わります。古いコミットの合格を新しいコミットへ引き継ぐなら、その変更が証拠の適用範囲を保っていることを別途立証する必要があります。検証対象をPR番号ではなくコミットで固定する方法は、PR番号ではなくExact SHAで検証対象を固定するで詳しく扱っています。
開発速度が上がるほど、レビュー待ちが増えることがある
現場で起きることを、単純な処理能力のモデルで考えます。仮にAI導入後、毎週12件の変更案が独立レビューへ到着し、レビュー側が週8件しか処理できないとします。両方の条件が変わらなければ、未処理の変更は週4件ずつ増える計算になります。4週間では16件です。これは架空の数値で、現実の到着・処理時間は変動します。
ここでAIを追加して実装案を週18件へ増やしても、レビュー処理能力が8件のままなら滞留は速くなります。経営者が「AIで開発生産性が上がった」と判断するのは早計です。レビュー側へ人員を追加する、変更の粒度を適切にする、確実に自動化できる検査を前段へ移す、依存作業をまとめるなどの選択肢を比較する必要があります。
ただし、あらゆるレビューを自動化すればよいとも限りません。独立性が必要な領域では、レビューの主体と責任を保持すること自体が品質条件です。単純なlintや型検査は機械化し、人の判断が必要な要件・セキュリティ・顧客動線の検査には十分な時間を配分する、という役割分担が考えられます。
まず計測したいのは、タスク数の合計より工程間の滞留です。たとえば「実装完了→レビュー開始」「レビュー完了→マージ」「マージ→公開ドメインで確認」の時間を分けて記録します。長く詰まっている区間ほど、追加投資の効果を検討する価値があります。
滞留を減らすための診断表
| 観測される症状 | 優先して調べる原因 | 小さく試す対策 |
|---|---|---|
| PRが多いのに利用者へ届かない | 後工程の処理能力、DONEの定義 | ステージ別の処理待ち時間を計測 |
| 毎回同じ手戻りが発生する | 受入条件の曖昧さ、初期テスト不足 | 着手前に反例と期待結果を固定 |
| CI成功後に本番事故が起きる | CIが守る範囲と実利用条件の差 | 公開URLでの操作・読戻しを追加 |
| 古いレビュー結果を使い回す | 版と証拠の紐付け不足 | commit SHAとレビュー対象を記録 |
| 承認の問い合わせで作業が止まる | 権限の範囲・期限・所有者が不明 | 操作単位の承認条件を前もって整理 |
改善策を同時に大量導入すると、効果の帰属が分かりにくくなります。まず一つの滞留工程を特定し、そこに作用する最小の変更を選ぶのが現実的です。
投資判断を変える指標は「生成時間」より「受入までの総費用」
評価単位を一週間の「受入済みタスク」にします。以下は考え方を説明する仮定の数字です。Netsujoの実測値とは区別します。
- AI導入で、20タスクの実装時間を各45分短縮したと仮定します。短縮は計900分。
- 追加レビューと検証に各25分かかったと仮定します。追加は計500分。
- 障害の復旧と人間の再指示が4回発生し、各70分かかったと仮定します。追加は計280分。
- この場合、差し引きの人的時間短縮は120分。ただし、20タスクのうち何件が利用受入まで到達したかは別に確認します。
開発費用の比較には、次の式を使えます。
検証済み成果1件あたり総費用
  = (AI/API費 + 開発費 + レビュー費 + セキュリティ確認費
     + 再試行・復旧費 + デプロイ確認費 + 人間の監督費)
÷ 合意したDONEへ到達した件数生成時間だけを分子から抜き出すと、後工程へ移った負担を見落とします。分母に「PR作成件数」や「AIの完了報告件数」を置くと、利用者に届いていない変更まで成果として数えてしまいます。削減した時間を事業価値として回収できたかという投資継続の判断は、AIエージェントの費用対効果はどう測る?で整理しています。
測るべき補助指標は、着手→受入までの時間、各工程の通過率、人間の再指示回数、復旧時間、リリース後の欠陥率です。最初はGitHub、CI、デプロイ、顧客受入の時刻を一つのタスクIDへ結び付けるだけでも構いません。
AI導入の効果をどう比較するか――小規模な計測設計
「導入後に完了件数が増えた」だけでは、AIの寄与を評価しきれません。作業の難易度が変わった、担当者が増えた、重要案件だけを後回しにした、といった理由でも数字は動きます。小さな会社ほど、少数の案件による偏りが大きくなります。
そこで、まず数週間の基準期間を取り、タスクを「軽微な画面修正」「既存機能の修正」「新しい連携」「権限・セキュリティ変更」などに分類します。受入条件が同じ仕事同士で比較するためです。計測が済んだら、次のような順に改善します。
最初の2週間:現状を観測する。 タスクID、着手時刻、実装完了時刻、独立QCの開始・終了、マージ、公開確認、必要な利用受入を記録します。AI利用費と人間の作業時間も合計します。進行中のタスクを無理に「失敗」と数えず、未受入として区別します。
次の2週間:一つだけ介入する。 たとえば既存の型検査・回帰テストを早い工程へ移し、QCへの差戻しを減らす施策を行います。レビューの権限や品質基準は同一のまま、改善対象の工程だけを変えます。
さらに数週間:採用を判断する。 同程度の仕事について、受入率、リードタイム、人間の再指示回数、欠陥率、総費用を比較します。件数が少ない場合は、統計的な断定を避け、個別タスクの理由まで確認します。期間や分類は例であり、業務量に応じて調整します。
費用はできれば変動費と固定費を分けます。APIの請求額に加え、エンジニアがレビューに使った時間、環境維持費、障害復旧に使った時間を含めます。逆に、すでに共通基盤があるなら、その構築費を毎回全額計上すると比較を歪めます。償却・配賦方法を固定したうえで見る必要があります。
数字を読むときの落とし穴
- 分母のすり替え:20件のPRが作られ、12件が受入済みなら、受入成果は12件です。未受入8件を消すのではなく別欄で保有します。
- 品質の後払い:導入週の費用が下がっても、翌月に重大障害が増えれば評価は変わります。監視する期間と欠陥の範囲を固定します。
- 難易度の変化:変更規模やリスク区分が大きく違う仕事の平均は参考値にとどめます。
- 人間の無償作業:経営者や上級エンジニアの再指示を費用ゼロとすると、本来のボトルネックが見えません。
KPIを大量に作る必要はありません。最初は「受入済み件数」「受入までの日数」「人間の介入時間」「障害・手戻り」の四つを、同じタスク集合へ紐付けてください。記録に欠損があれば、その割合も記します。
どこへ投資するか:安全と前進の両方を設計する
品質や権限の制約を弱めれば、見かけ上の完了率は上がります。しかし重大な誤操作の期待損失が増えれば、経済合理性はありません。
順序としては、まず完了条件と必要証拠を決め、その後に詰まっている工程を計測します。レビュー入力が足りないなら内容と網羅性を保持して受け渡す。権限不足なら正規の承認主体へ接続する。外部サービスの結果が不明なら、その側の状態を読み戻して二重実行を防ぐ。拒否された操作と独立したテスト・資料準備は、許可された範囲で継続できます。
NetsujoのOSS Agent Role Contracts は、エージェントの役割・作業範囲・レビュー分離などの宣言の矛盾を実行前に検査するための一つの部品です。PASSは実行権限の授与や、レビュー・本番成功の保証を意味しません。実行時の強制、主体の認証、独立レビュー、復旧、実利用受入は、別の仕組みで確かめます。
同じ機能を一回だけ試す短期プロトタイプなら、重い制御基盤を用意するより小さなテストと人的確認で済む場合があります。一方、複数のAIが長期間にわたり本番へ変更する環境では、証拠・権限・復旧を構造化する投資の優先度が上がります。
どこまで仕組み化し、どこは人が判断するか
AIエージェントの運用を製品として考える場合も、最初の投資は大きな自律実行基盤とは限りません。費用対効果は作業の頻度とリスクで大きく変わります。
第1段階:記録を揃える。 一件の仕事について、DONE、現在の版、未完了工程、次の責任者を一箇所で見られるようにします。GitHub Issueと既存CIを用いた運用でも始められます。この段階で減らしたいのは、状況確認の往復です。
第2段階:拒否条件を機械化する。 実装者が許されたファイル以外を書き換えようとした場合や、古い版のレビューを新しい版へ流用しようとした場合に、適切に停止できるようにします。すべての拒否を一つのエラーへまとめず、権限不足・検証失敗・外部結果不明を区別します。
第3段階:実行と受入を結ぶ。 必要に応じて実行管理、再開、独立レビュー、配備結果の読戻しを接続します。停止した操作の迂回を防ぎつつ、その停止に依存しない作業は続けられることが目標です。ここでは実行ログの多さより、同じ仕事が途中で失われず、正しい条件で完了することを評価します。
これは導入順序の提案です。Netsujoの各仕組みの提供範囲と受入状況は個別に確認する必要があります。公開OSSで検証できる部分、実際の開発環境で観測できる部分、顧客利用で初めて確認できる部分は、公開する際も分けて説明します。
高リスクな顧客データ変更や本番権限の移管があるなら、人的承認は必要な制御です。一方、承認を受けるための差分・版・費用・影響範囲を自動で整理することには、十分に改善余地があります。人間の判断を減らす対象は、判断そのものより、判断に必要な証拠を集め直す反復作業から始めるのが妥当です。
次に経営責任者が確認する五つの問い
AI開発の成果報告を受け取ったら、次を確認します。
- DONEは何か。コード・マージ・本番・利用受入のどこまでか。
- 現在のHEADと必要なレビュー・テストの対象は一致するか。
- 拒否や失敗が発生した場合、誰が解除条件を判断し、何を安全に進められるか。
- 受入済み成果1件に、AI/API費と人間の時間が合計いくらかかったか。
- 次の一件で、再指示や復旧時間を減らす再利用可能な仕組みは何か。
AI導入の成否は、早く出力したかという問いから、利用者の価値へ何件届けられたか、その総費用が改善したかへ移して判断することを勧めます。
AIエージェントを含む開発体制の設計・検証については、Netsujoへご相談ください。
---
出典・確認範囲(2026年10月22日)
- Black Duck / UserEvidence, *The State of AI-Powered Software Development*(2026年3月調査、831人):https://www.blackduck.com/resources/analyst-reports/state-of-ai-powered-software-development.html
- Stack Overflow, *2026 Developer Survey — Trust in AI tools*:https://survey.stackoverflow.co/2026/ai/data/ai-trust
- LangChain, *State of Agent Engineering*(2026年6月12日):https://www.langchain.com/state-of-agent-engineering
- Agent Role Contracts 公開ソース:宣言検査の能力と限界。
自社のAI開発で、実装・レビュー・本番受入までの工程や総費用を整理したい場合はご相談ください。
Netsujoへ相談する